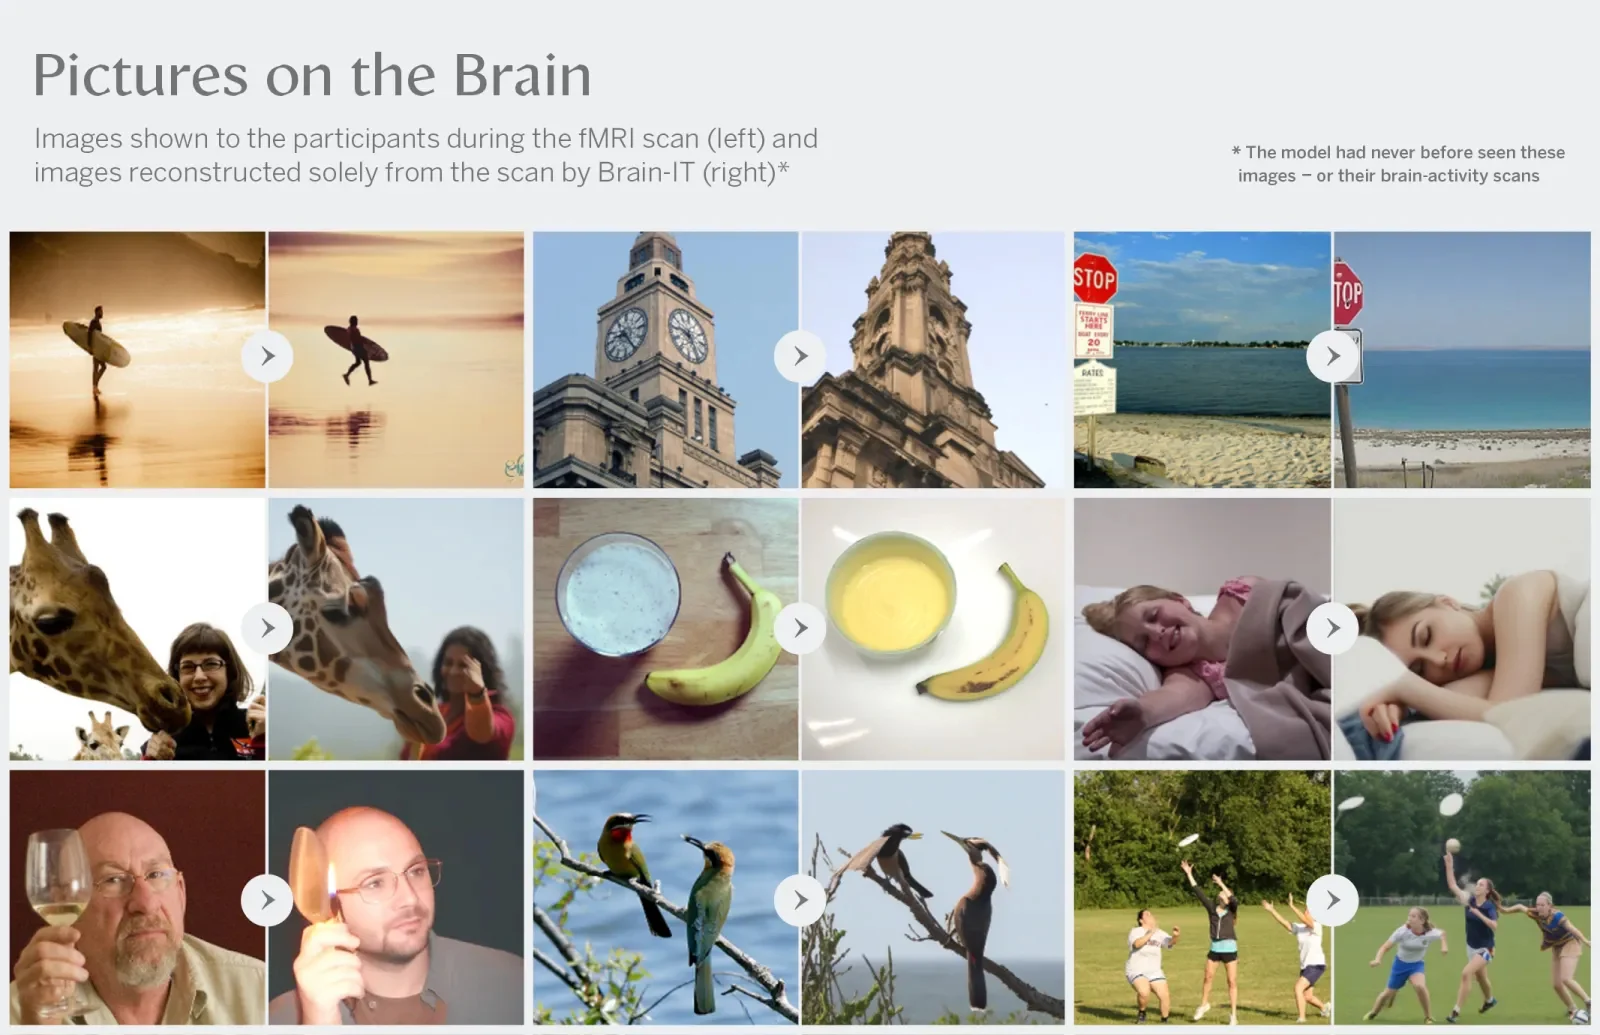
Исследователи создали ИИ-модель, которая «читает» активность мозга и с высокой скоростью и точностью восстанавливает то, на что смотрит человек. Результаты выглядят впечатляюще: на иллюстрации ниже слева показан оригинал, который видел участник эксперимента, а справа — картинка, собранная нейросетью.
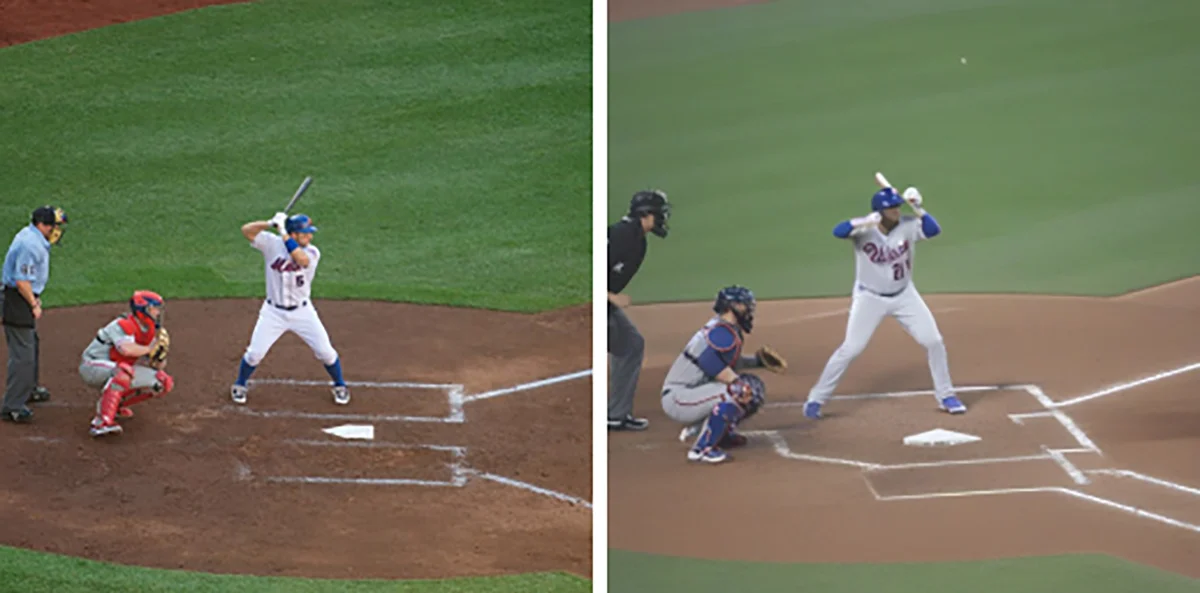 Источник изображения — petapixel.com
Что такое Brain-IT
Модель получила название Brain-IT. Её разработали в лаборатории профессора Михаль Ирани в Институте науки Вайцмана. Brain-IT обучена находить похожие паттерны мозговой активности, которые возникают у разных людей при просмотре изображений. В отличие от более ранних ИИ-моделей, она затем воссоздаёт эти картинки с высокой точностью, а весь процесс занимает около часа вместо нескольких часов, которые требовались раньше.
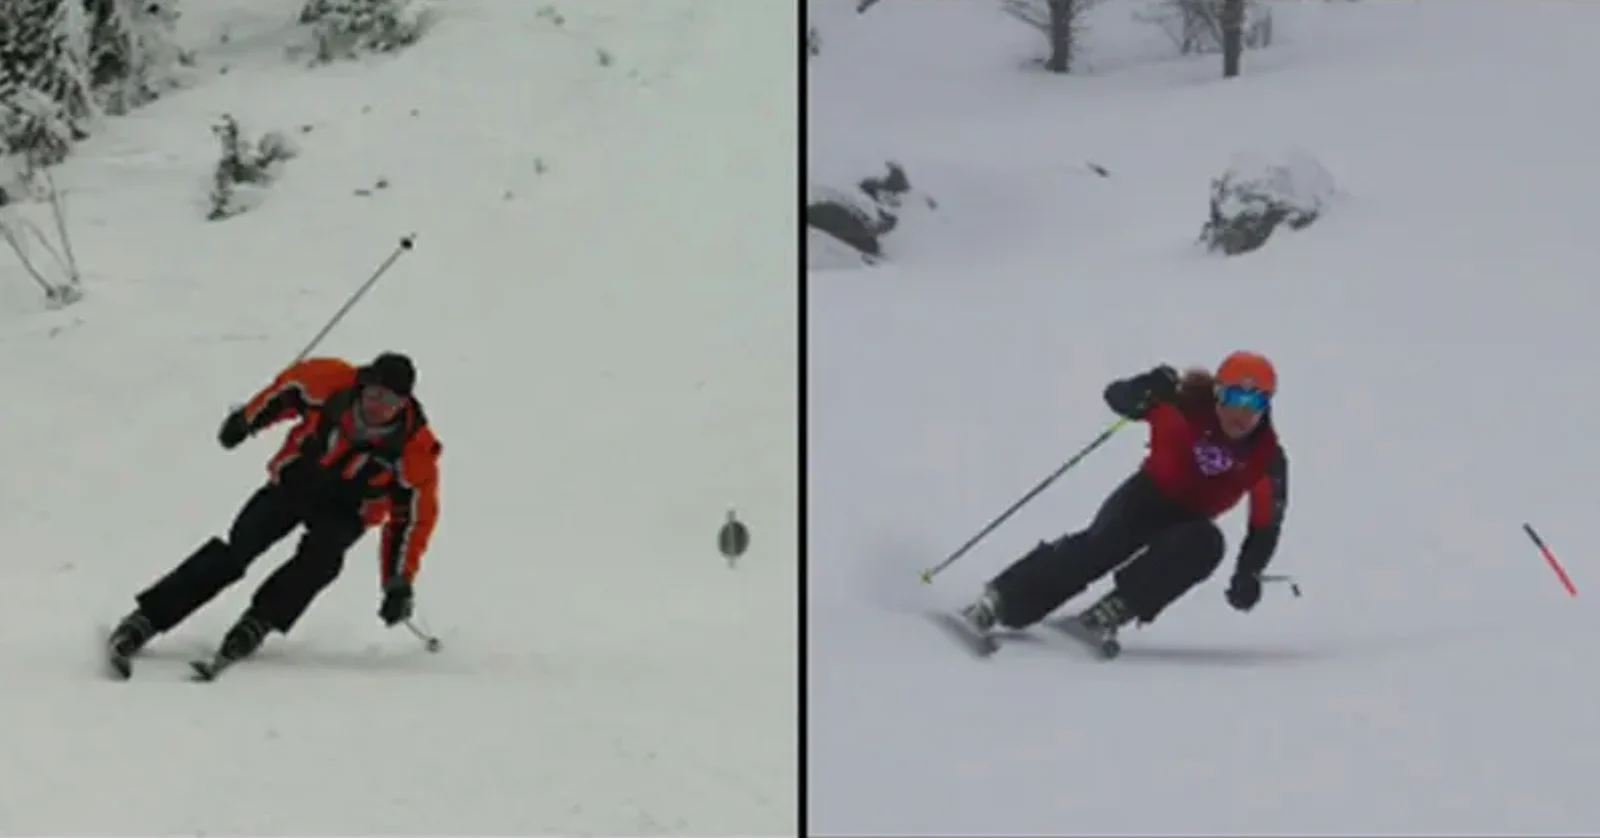 Источник изображения — petapixel.com
Чем Brain-IT лучше предшественников
«Сегодня существуют модели, которые переводят активность мозга в изображения, и они даже дают впечатляющие реконструкции, довольно хорошо сохраняющие смысл картинки, — говорит Ирани в официальном заявлении. — Однако они склонны ошибаться в базовых признаках, таких как композиция и цвет».
По словам Ирани, новая модель превосходит прежние и в передаче содержания изображения, и в деталях. «Более того, если любой другой модели нужны десятки часов сканирований мозга, чтобы научиться „читать“ нового человека, то нашей требуется всего один час», — поясняет она.
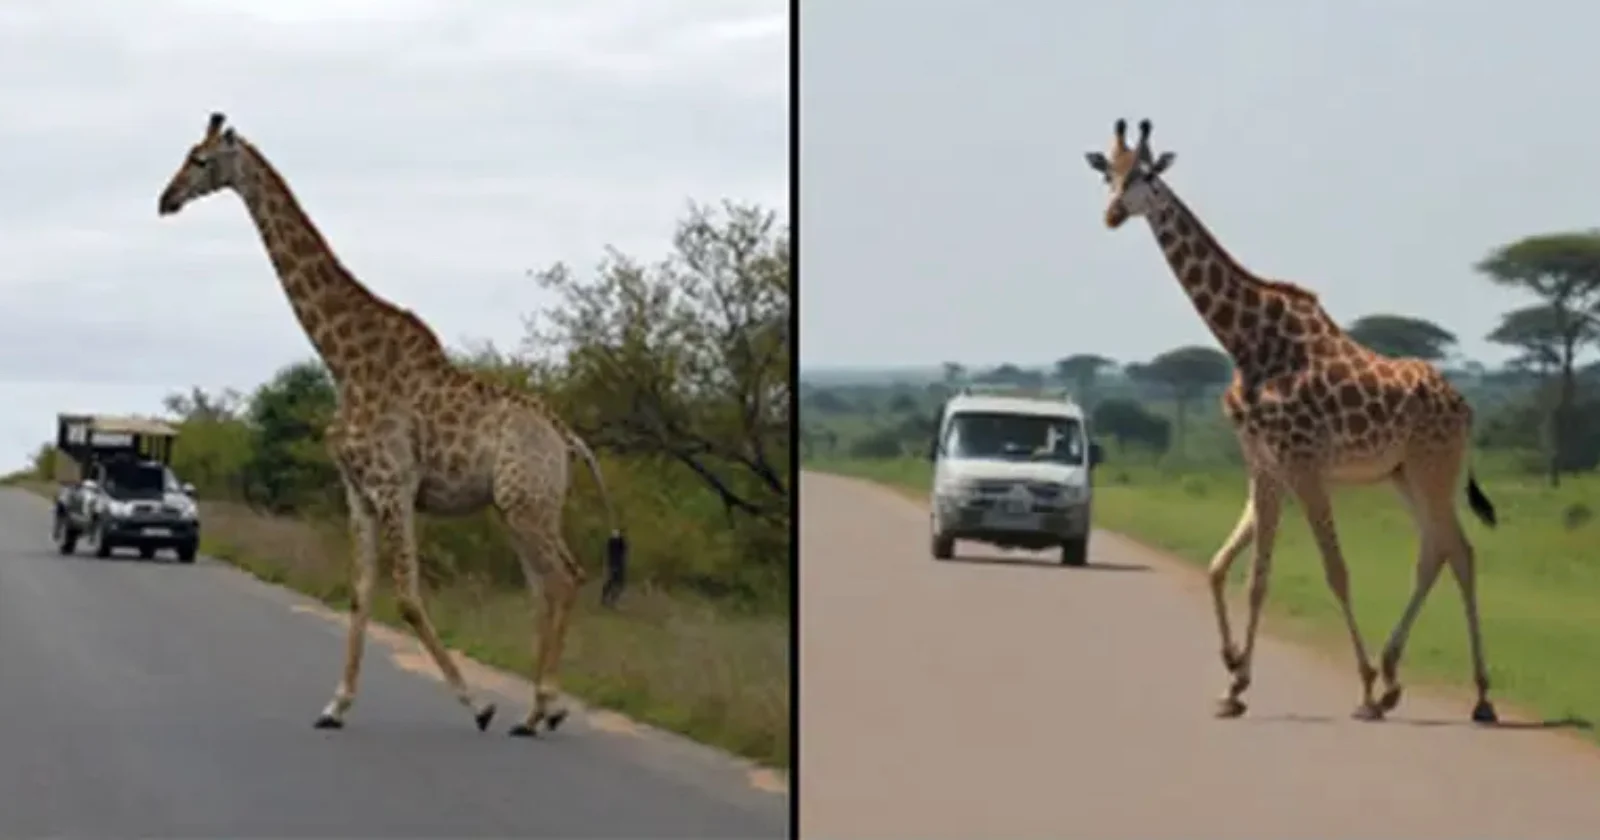
Важно, что речь идёт о реконструкции картинок, которые человек видит прямо во время сканирования: модель сопоставляет мозговую активность с изображением, а не угадывает произвольные мысли. Примеры таких реконструкций приведены ниже.
Как обучали систему
Систему обучали более чем на 70 000 изображений, которые показывали восьми людям, пока их мозг сканировали. Восемь человек — сравнительно небольшой набор данных для подобных исследований, поэтому учёные разработали «энкодер»: он находит закономерности, общие для мозга разных людей, и предсказывает мозговую активность по изображению.
Чтобы построить энкодер, исследователи разделили каждый скан мозга примерно на 40 000 крошечных участков — вокселей — и измерили, как каждый из них реагирует на разные картинки. С помощью ИИ в этих изображениях также выделяли визуальные признаки, например цвета и расположение объектов, а ещё то, что на них изображено, — скажем, лица или еду.
Сопоставив эти признаки с мозговой активностью всех восьми участников, учёные выявили паттерны, которые повторяются в разных мозгах, хотя каждый мозг реагирует по-своему. Эти общие паттерны удалось сгруппировать в 128 функциональных областей, участвующих в обработке изображений.
 Источник изображения — petapixel.com
«В ходе обучения энкодер самостоятельно выделил 128 функциональных областей, общих для всех людей и выполняющих определённые роли в обработке изображений, — поясняет Ирани. — Некоторые из них знакомы нейробиологам, а другие совершенно новые. Например, мы обнаружили разделение ролей внутри области мозга, которая обрабатывает изображения мест, — PPA: одна её часть реагирует на сцены в помещении, а другая — на сцены на открытом воздухе».
Как работает связка энкодера и декодера
Как сообщает MIT Technology Review, затем команда использовала энкодер вместе с «декодером», чтобы проверить, можно ли с помощью найденных паттернов восстанавливать изображения по мозговой активности. Энкодер предсказывает, как должна выглядеть мозговая активность человека, когда он смотрит на конкретную картинку, а декодер работает в обратную сторону: по активности мозга реконструирует изображение. Многократно обучая обе модели совместно, исследователи добивались всё более точных реконструкций.
Зачем это нужно
Авторы разработки считают, что технология Brain-IT в перспективе может помочь людям с параличом общаться, а учёным — получить более эффективный способ изучать, как мозг обрабатывает изображения.
Brain-IT в цифрах
- Более 70 000 изображений показали участникам эксперимента.
- 8 человек участвовали в обучении модели.
- Около 40 000 вокселей в каждом скане мозга.
- 128 функциональных областей выделил энкодер.
- Около 1 часа сканирований нужно, чтобы модель научилась «читать» нового человека.