Всё больше программного кода сегодня создаётся с участием искусственного интеллекта — и теперь у этого утверждения есть точные цифры. GitHub, крупнейший в мире репозиторий кода, сообщил, что за прошедший год нарастил инфраструктуру на 4 миллиона процессорных ядер, 160 ПБ хранилища и 50 Тбит/с сетевой пропускной способности, чтобы справиться с наплывом кода, сгенерированного ИИ.
 Источник изображения — tomshardware.com
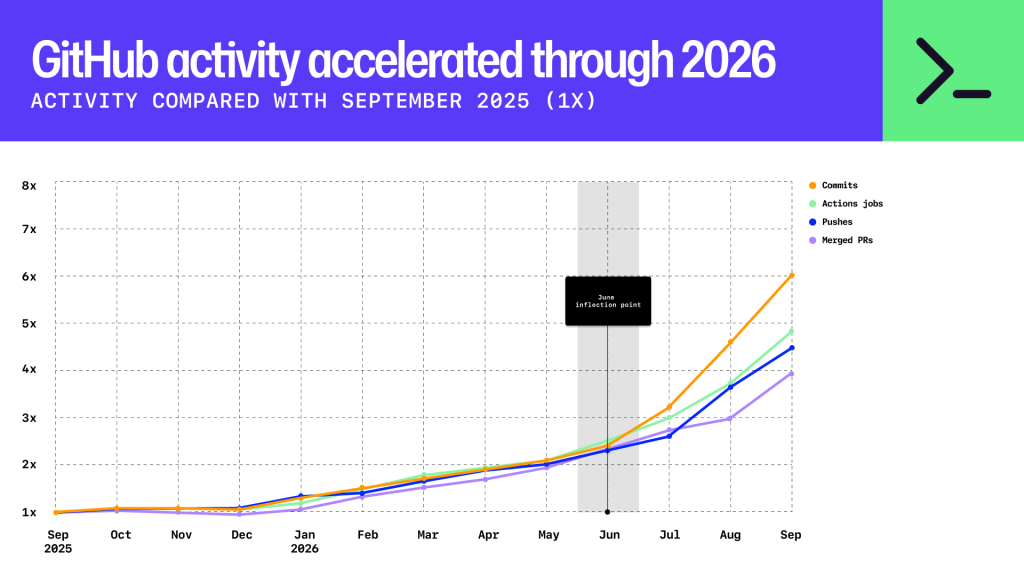
Согласно техническому отчёту GitHub, активность в репозиториях резко выросла год к году. Число коммитов (добавление и удаление кода) увеличилось в шесть раз, а количество принятых pull request'ов — завершённых функций или исправлений — выросло вчетверо.
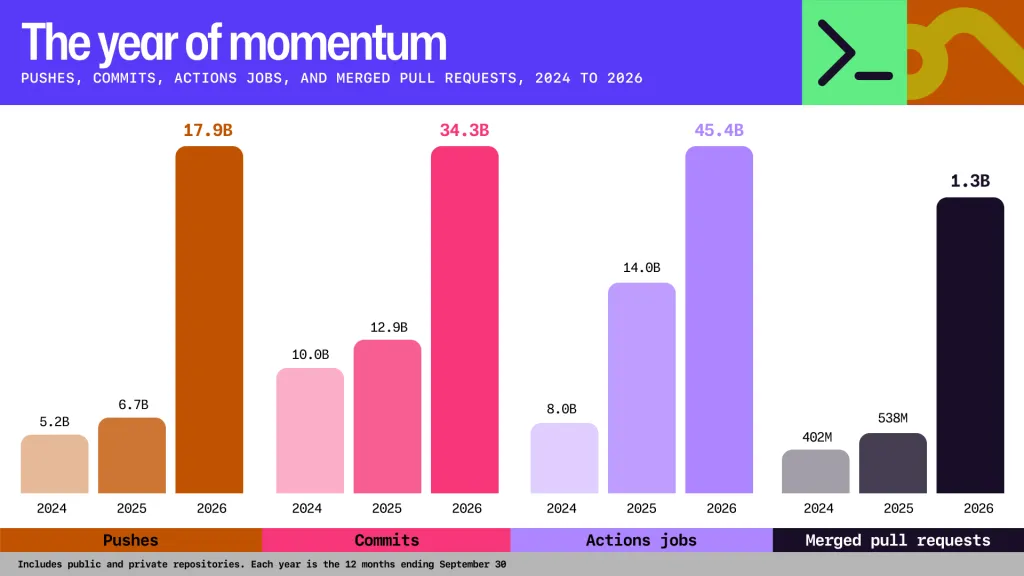
Сами множители впечатляют, но ещё нагляднее экспоненциальный характер роста. Полгода назад, в апреле, фиксировалось около 1,4 млрд коммитов в месяц; к августу показатель поднялся до 2,9 млрд, а в сентябре достиг 7,4 млрд. За последние 12 месяцев на платформе произошло 17,9 млрд отправок кода — больше, чем за весь 2024 и 2025 годы вместе взятые.
 Источник изображения — tomshardware.com
Причиной такого головокружительного роста объёма кода ожидаемо называют агентный ИИ — он же вынудил и обновить, и переосмыслить всю технологическую инфраструктуру. К сентябрю более 40% pull request'ов инициировались агентом против 17% в марте 2026 года. Более того, репозитории, которые изначально запускаются с помощью ИИ, в среднем показывают в восемь раз больше активности, чем проекты, создаваемые вручную.
Вся эта активность создаёт непропорциональную нагрузку на конвейеры CI/CD. В современной разработке каждый коммит или слияние pull request'а запускает множество действий: проверку оставшихся пометок «to-do», автоматическое форматирование кода (линтинг), а также прогон модульных и интеграционных тестов, которые убеждаются, что новый код не ломает существующую функциональность и корректно работает со связанными программами, сервисами и API.
 Источник изображения — tomshardware.com
Запуск всех этих процессов на каждый коммит и pull request привёл к тому, что аппаратные потребности GitHub резко выросли, потребовав огромных вычислительных мощностей и пропускной способности ввода-вывода. Нагрузка оказалась настолько высокой, что компании пришлось перепроектировать бэкенд, максимально отделив хранилище от вычислений. Учитывая скорость роста спроса, следующее расширение инфраструктуры, судя по всему, не за горами.
Для разработчиков из СНГ эта статистика — наглядный показатель того, как быстро ИИ-ассистенты становятся штатным инструментом: нагрузка смещается с написания кода на его проверку и ревью, а требования к CI-инфраструктуре и автотестам выходят на первый план.