Тензорные процессоры (TPU) компании Google — её собственные ИИ-чипы — теперь обслуживают искусственный интеллект в продакшене у Meta* (создателя широко используемого фреймворка PyTorch) благодаря новой, нативной для PyTorch версии движка инференса SGLang, о чём сообщается в блоге Google для разработчиков. Аналогичную версию vLLM, ещё одного популярного движка инференса, также представили с открытым исходным кодом.
 Источник изображения — tomshardware.com
Раньше оба движка работали на TPU через собственный ИИ-фреймворк Google — JAX. Новые версии делают это оборудование нативным вариантом для PyTorch — по большей части без переписывания кода.
«SGLang-TorchTPU уже работает в продакшене у Meta» после «тесного трёхстороннего сотрудничества между Meta, Google и командой SGLang», — заявил руководитель направления PyTorch-TPU в Meta Цзунвэй Чжоу. Эта команда работает в стартапе RadixArk, основанном создателями SGLang, который разрабатывал движок вместе с Google и Meta. По его словам, движок даёт Meta «на удивление зрелый, нативный для PyTorch стек обслуживания».
Яна ван Гройнен, директор по инженерии PyTorch в Meta, добавила в посте Google о TorchTPU, что Meta «не может быть привязана к единственной аппаратной архитектуре» и что TorchTPU «позволяет развёртывать PyTorch-нагрузки на TPU от Google». В Google отметили, что разрабатывали TorchTPU совместно с командой PyTorch из Meta.
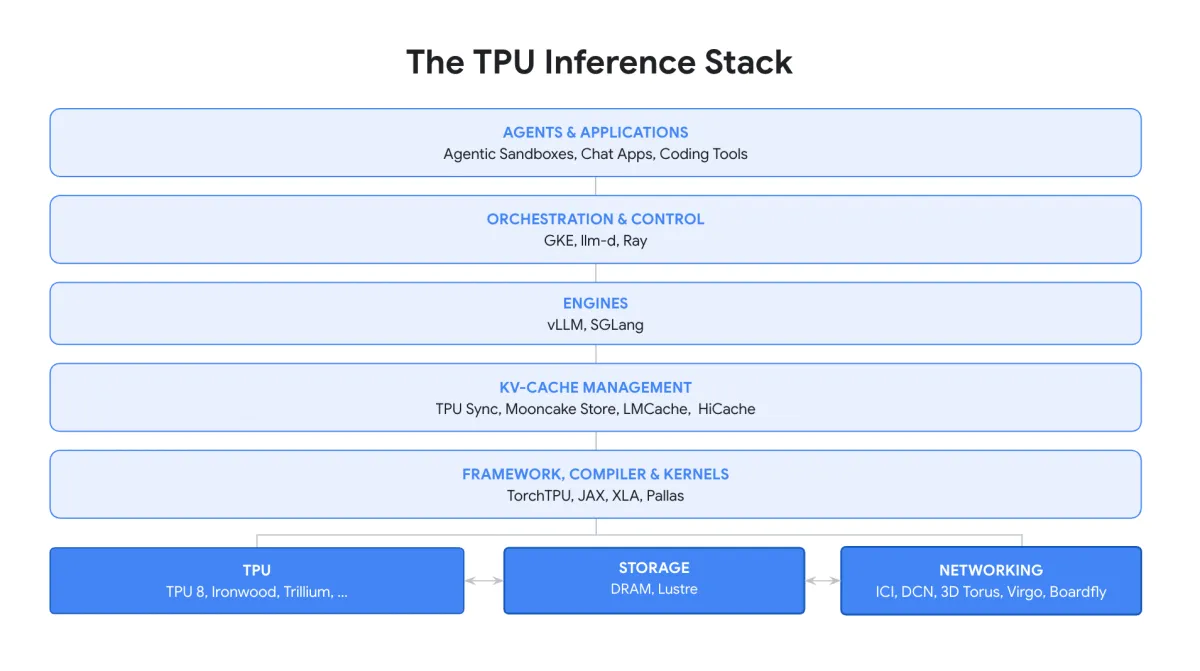 Источник изображения — tomshardware.com
Это не первая попытка Meta задействовать TPU. Google называет PyTorch/XLA — более ранний мост от PyTorch к TPU — «предшественником» нового TorchTPU, а по данным SemiAnalysis, исследовательские команды Meta использовали TPU через этот мост с 2020 по 2023 год, прежде чем Meta расторгла контракты. Усилия Google по переносу PyTorch на TPU были нацелены в первую очередь на Meta, которая не хотела мигрировать на JAX.
Хотя неясно, где именно размещаются продакшен-TPU компании Meta, прошлогодние переговоры, по сообщениям, включали аренду Google Cloud TPU в 2026 году с последующей закупкой в 2027-м; позже Meta, как сообщалось, подписала многолетнее соглашение об аренде.
СРОЧНЫЕ НОВОСТИ 🚨🚨: СЕГОДНЯ META ПОДТВЕРЖДАЕТ, ЧТО ЗАПУСКАЕТ ИНФЕРЕНС НА TPU В ПРОДАКШЕНЕ. Что это значит для «рва» вокруг CUDA? Для тех, кто читает нашу открытую рассылку, это не сюрприз: ещё 28 ноября 2025 года мы публично писали, что Meta — клиент TPU и что у неё много инженеров, работающих с TPU. В нашей модели цепочки поставок ускорителей есть детали о закупках TPU компанией Meta! 21 октября 2026
Анонс прозвучал на следующий день после того, как Amazon сообщила об открытии исходного кода TorchNeuron — собственного нативного PyTorch-бэкенда для чипов Trainium2 и Trainium3 — на той же конференции PyTorch Conference. Оба шага, похоже, направлены на ослабление программной зависимости от Nvidia.
Что касается производительности, то настроенная конфигурация vLLM, обслуживающая открытую модель Kimi K3 на 2,8 трлн параметров от Moonshot AI, по сообщениям, выдаёт более 700 токенов в секунду для одного пользователя на TPU седьмого поколения Ironwood. Эти данные приводит Inferact — стартап основателей vLLM, помогавший Google создать vLLM-TorchTPU. В тесте использовались 16 чипов Ironwood со спекулятивным декодированием против опубликованной конфигурации vLLM на 16 ускорителях Nvidia GB200, которая достигла 452 токенов в секунду. Для моделей Kimi K3 и Qwen 3.8 27B ядра дают примерно в 1,4–2 раза больше пропускной способности, чем базовая конфигурация на GB200, при малых размерах батча и без спекулятивного декодирования.
SGLang-TorchTPU продолжит добавлять модели, начиная с DeepSeek V4.1 Flash и Reflection Beam. Команда также стремится к поддержке новых открытых моделей на TPU «в день релиза» (Day 0) к первому кварталу 2027 года, по данным RadixArk. Google, Meta и RadixArk обещают рассказать больше на SGLang Summit 2026, который пройдёт 12–13 ноября в Сан-Франциско.
* Принадлежит компании Meta, деятельность которой признана экстремистской и запрещена на территории Российской Федерации. Социальные сети Facebook и Instagram запрещены в РФ.