На ежегодной конференции Huawei Connect компания обновила дорожную карту своих ИИ-ускорителей: сроки выхода семейства Ascend 960 сдвинулись на более ранние, впервые раскрыты характеристики будущих чипов Ascend 970 и 980, представлена новая архитектура Peerium на базе шины UnifiedBus, а линейка вертикально интегрированной ИИ-инфраструктуры расширена.
 Источник изображения — tomshardware.com
Для Huawei это часть более крупной стратегии: на фоне экспортных ограничений на поставки ускорителей Nvidia в Китай компания старается выстроить полностью собственный стек ИИ-инфраструктуры — от процессоров и памяти до межсоединений и программного стека. Новая архитектура Peerium на базе фирменной шины UnifiedBus как раз отвечает за объединение тысяч ускорителей в единые вычислительные кластеры класса SuperPoD, где важна не только производительность отдельного чипа, но и скорость обмена данными между ними.
Переход на архитектуру SIMD+SIMT
Почти десять лет ускорители Huawei Ascend строились на архитектуре SIMD, а сейчас компания переходит на новую SIMD+SIMT, которая сочетает векторную обработку данных с параллелизмом на уровне потоков. SIMD-часть отвечает за операции с параллельными данными, а SIMT — за задачи с большим числом ветвлений, что в сумме должно повысить утилизацию оборудования и производительность на самых разных ИИ-нагрузках.
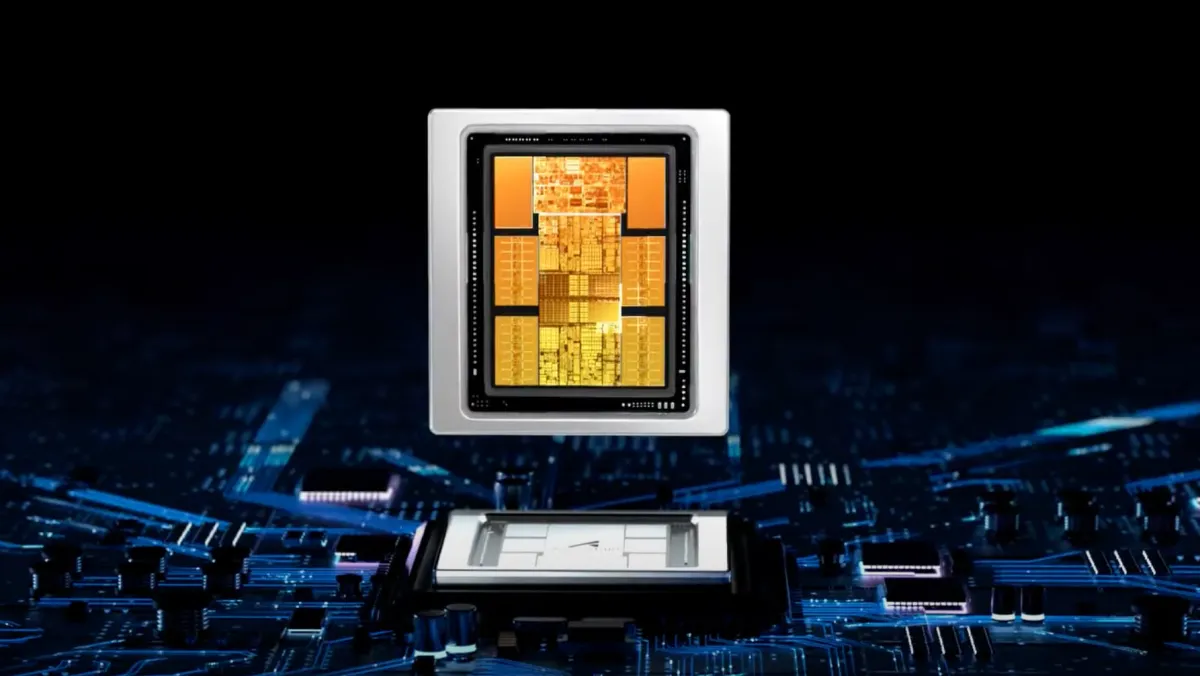
Первыми чипами на новой архитектуре стали Ascend 950PR — для предзаполнения контекста и рекомендательных систем, и Ascend 950DT — для декодирования и обучения моделей. По словам Huawei, системы Atlas 950 SuperPoD на базе платформы Ascend 950 уже применяются в промышленных масштабах, хотя подробностей компания не привела. Тесты обучающего чипа 950DT дали «хорошие результаты», и Huawei рассчитывает, что многие китайские разработчики ИИ начнут обучать модели на системах с 950DT уже в 2027 году. При этом компания признала, что производственных мощностей пока не хватает для удовлетворения внутреннего спроса.
 Источник изображения — tomshardware.com
Atlas 950 SuperPoD растёт медленнее заявленного
В сентябре 2025 года Huawei анонсировала максимальную конфигурацию Atlas 950 SuperPoD: 2048 процессоров Kunpeng 950, 8192 ускорителя Ascend 950DT, 160 стоек (128 вычислительных и 32 коммуникационные), совокупная производительность 8 FP8 EFLOPS и 16 FP4 EFLOPS, а также 16 Пбайт/с суммарной пропускной способности межсоединений. Однако в июле 2026 года компания публично показала реальную инсталляцию Atlas 950 SuperPoD всего на 256 процессоров и 1024 ускорительные карты — заметно скромнее максимальной конфигурации. Архитектура по-прежнему описывается как масштабируемая до 8192 ускорителей, но на сайте компании такой конфигурации нет, поэтому судить о реальном масштабе промышленного применения сложно.
Скорость внедрения Atlas 950 SuperPoD, судя по всему, ниже ожидаемой — возможно, из-за нехватки поставок, а возможно из-за того, что новая архитектура требует серьёзной переработки программного обеспечения. Так или иначе, Atlas 950 SuperPoD во многом выполняет роль «обкатки» перед выходом более мощных ускорителей линейки Ascend 960 и её преемников.
Характеристики Ascend 960DT и 960PR
Семейство Ascend 960 откроет чип 960DT, который должен официально выйти в первом квартале 2027 года — на три квартала раньше первоначального плана. Следом, в третьем квартале 2027 года, на квартал раньше запланированного, выйдет 960PR.
Источник изображения — tomshardware.com
- Ascend 960DT: 2 FP8 PFLOPS, 4 FP4 PFLOPS, 288 Гбайт памяти с пропускной способностью 9,6 Тбайт/с, межсоединение на 2,2 Тбайт/с
- Ascend 960PR: 2 FP8 PFLOPS для обучения и 8 FP4 PFLOPS для инференса (вдвое больше, чем анонсировалось ранее), 192 Гбайт памяти с пропускной способностью 2,4 Тбайт/с, межсоединение на 2,2 Тбайт/с
Для сравнения: ускоритель Nvidia VR200, ожидаемый в четвёртом квартале 2026 года, обещает 35 PFLOPS NVFP4 при обучении и 50 PFLOPS NVFP4 при инференсе, а также 288 Гбайт памяти HBM4.
Разница между режимами FP8 и FP4 объясняется тем, для чего используется чип: восьмибитная точность FP8 нужна там, где важна точность вычислений, — прежде всего при обучении моделей, а более грубый четырёхбитный формат FP4 позволяет резко нарастить пропускную способность там, где точность можно принести в жертву скорости, — в первую очередь при инференсе, то есть при выдаче готовых ответов уже обученной моделью. Именно поэтому Huawei приводит для каждого чипа отдельные показатели FP8 и FP4, а не единую метрику производительности.
Ascend 970 и 980: горизонт 2028–2029 годов
«Мы развиваем линейку чипов Ascend по циклу «одно поколение в год», — заявил в своём выступлении заместитель председателя совета директоров и ротационный председатель Huawei Дэвид Ван. — В 2028 и 2029 годах мы выпустим чипы Ascend 970 и 980 соответственно. Благодаря закону масштабирования Tau (τ) не только продолжит удваиваться вычислительная производительность, но и заметно вырастут пропускная способность и объём памяти, а также пропускная способность межсоединений».
Huawei переходит на цикл выпуска ускорителей Ascend раз в год и обещает, что за счёт закона масштабирования Tau характеристики новых чипов продолжат удваиваться от поколения к поколению.
- Ascend 970 (2028 год): 3,6 FP8 PFLOPS, 14 FP4 PFLOPS, 288 Гбайт памяти с пропускной способностью 14,4 Тбайт/с, межсоединение на 4,4 Тбайт/с
- Ascend 980 (2029 год, предварительные данные): 7,2 FP8 PFLOPS, 28 FP4 PFLOPS, 384 Гбайт памяти с пропускной способностью 38,4 Тбайт/с, межсоединение на 8 Тбайт/с
Сдвиг выхода Ascend 960DT сразу на несколько кварталов раньше плана — само по себе серьёзное достижение. Но куда показательнее то, что производительность в FP4 у Ascend 960PR выросла вдвое по сравнению с изначальными ожиданиями: это указывает на существенную переработку низкоточных вычислительных блоков, а не просто на изменение частот или памяти. Четырёхкратное превосходство FP4 над FP8 станет отличительной чертой и будущих Ascend 970 и 980.