Ради простоты инженеры постоянно идут на упрощения: провода будто бы не имеют сопротивления, кварцевые генераторы выдают идеально точную частоту, а память компьютера работает предельно предсказуемо — записал данные по адресу, а потом спокойно считал их обратно. Разработчики проекта FEX-Emu смотрят на это иначе. Как только в игру вступают кэши и, тем более, несколько процессорных ядер, всё оказывается совсем не так просто.
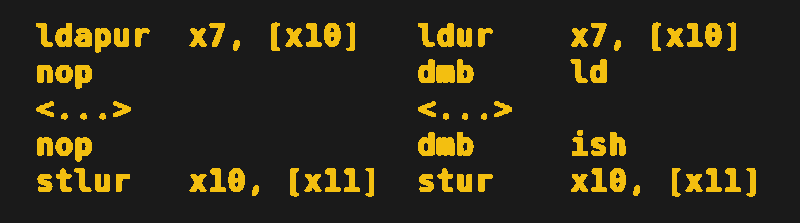
Суть проблемы такова: если одно ядро (точнее, ведущее устройство на шине, bus master) записало значение в память, увидит ли это новое значение другое ядро — и в какой момент? Архитектура x86 с её моделью Total Store Ordering (TSO) даёт программисту жёсткие гарантии того, когда операции чтения и записи становятся видимыми. А вот ARM сознательно использует более слабую модель памяти, допускающую куда более агрессивную перестановку операций ради производительности и энергоэффективности.
Теоретически эмулятор может это компенсировать, переводя обычные обращения к памяти x86 в ARM-операции с семантикой acquire/release. Проблема в том, что делать так почти для каждого обращения к памяти — крайне дорого. Свежие расширения ARM вроде LRCPC заметно облегчают задачу, а Apple пошла ещё дальше и добавила в чипы Apple Silicon совместимый с x86 режим TSO: благодаря ему обычные чтения и записи ведут себя именно так, как ожидает транслированный x86-код, почти без накладных расходов. Во многом на этом и держится скорость трансляторов вроде Rosetta 2.
Невыровненные доступы и атомарные операции
Куда неприятнее ситуация с невыровненными обращениями и атомарными операциями. Программы для x86 сплошь и рядом читают и пишут данные так, как ARM счёл бы недопустимо невыровненным, а сама x86 даёт на удивление сильные гарантии атомарности в пределах одной кэш-линии. В результате FEX порой приходится перехватывать исключения выравнивания и на лету дописывать в транслированный код барьеры памяти.
Ещё хуже обстоят дела с так называемыми split-lock-операциями, которые захватывают блокировку сразу на двух кэш-линиях: часть из них требует обращений через ядро ОС и обработчики сигналов и может выполняться в сотни и тысячи раз медленнее обычного. Новые ядра Oryon от Qualcomm улучшают ситуацию, поддерживая когерентные атомарные операции на уровне кэш-линии, а Valve выпустила оптимизацию для ядра Linux, которая напрямую разбирается с частью проблемных невыровненных атомарных обращений — важный шаг для игр на портативных ПК.
Память видеокарты и падение до 1 FPS
Отдельный и особенно болезненный случай — запись в область памяти видеокарты с режимом write-combining. Игры для ПК часто рассчитывают на x86-семантику упорядочивания, когда пишут в некэшируемые буферы, предназначенные для дискретной видеокарты. У ARM пока попросту нет чистого аналога для части таких операций, и в худшем случае FEX намерил падение пропускной способности более чем в 800 раз — этого достаточно, чтобы уронить некоторые игры ниже 1 кадра в секунду. Системы с общей памятью (UMA) чувствуют себя заметно лучше: драйверы часто могут подменить такую память обычной, когерентной по кэшу.
Всё это — наглядная иллюстрация того, что современные эмуляторы всё меньше занимаются переводом инструкций и всё больше — воспроизведением десятилетий архитектурных допущений, на которые тихо опирается софт. Далеко не всем эмуляторам нужна такая точность, и часто «достаточно хорошо» — вполне рабочий вариант. Но иногда требуется воссоздание, которое ведёт себя ровно как оригинал, вплоть до отдельного такта.