С 2020 года индустрия искусственного интеллекта была одержима идеей обучения всё более крупных моделей: большие языковые модели (LLM) выросли от миллионов параметров до триллионов. Подход себя оправдал — самая крупная версия GPT-3 от OpenAI, представленная в 2020 году, верно отвечала лишь на 43,9% вопросов в популярном тесте на знания и рассуждение. Уже к 2024 году модель GPT-4o набрала на том же тесте 88,7% — результат, сопоставимый с оценками экспертов-людей.
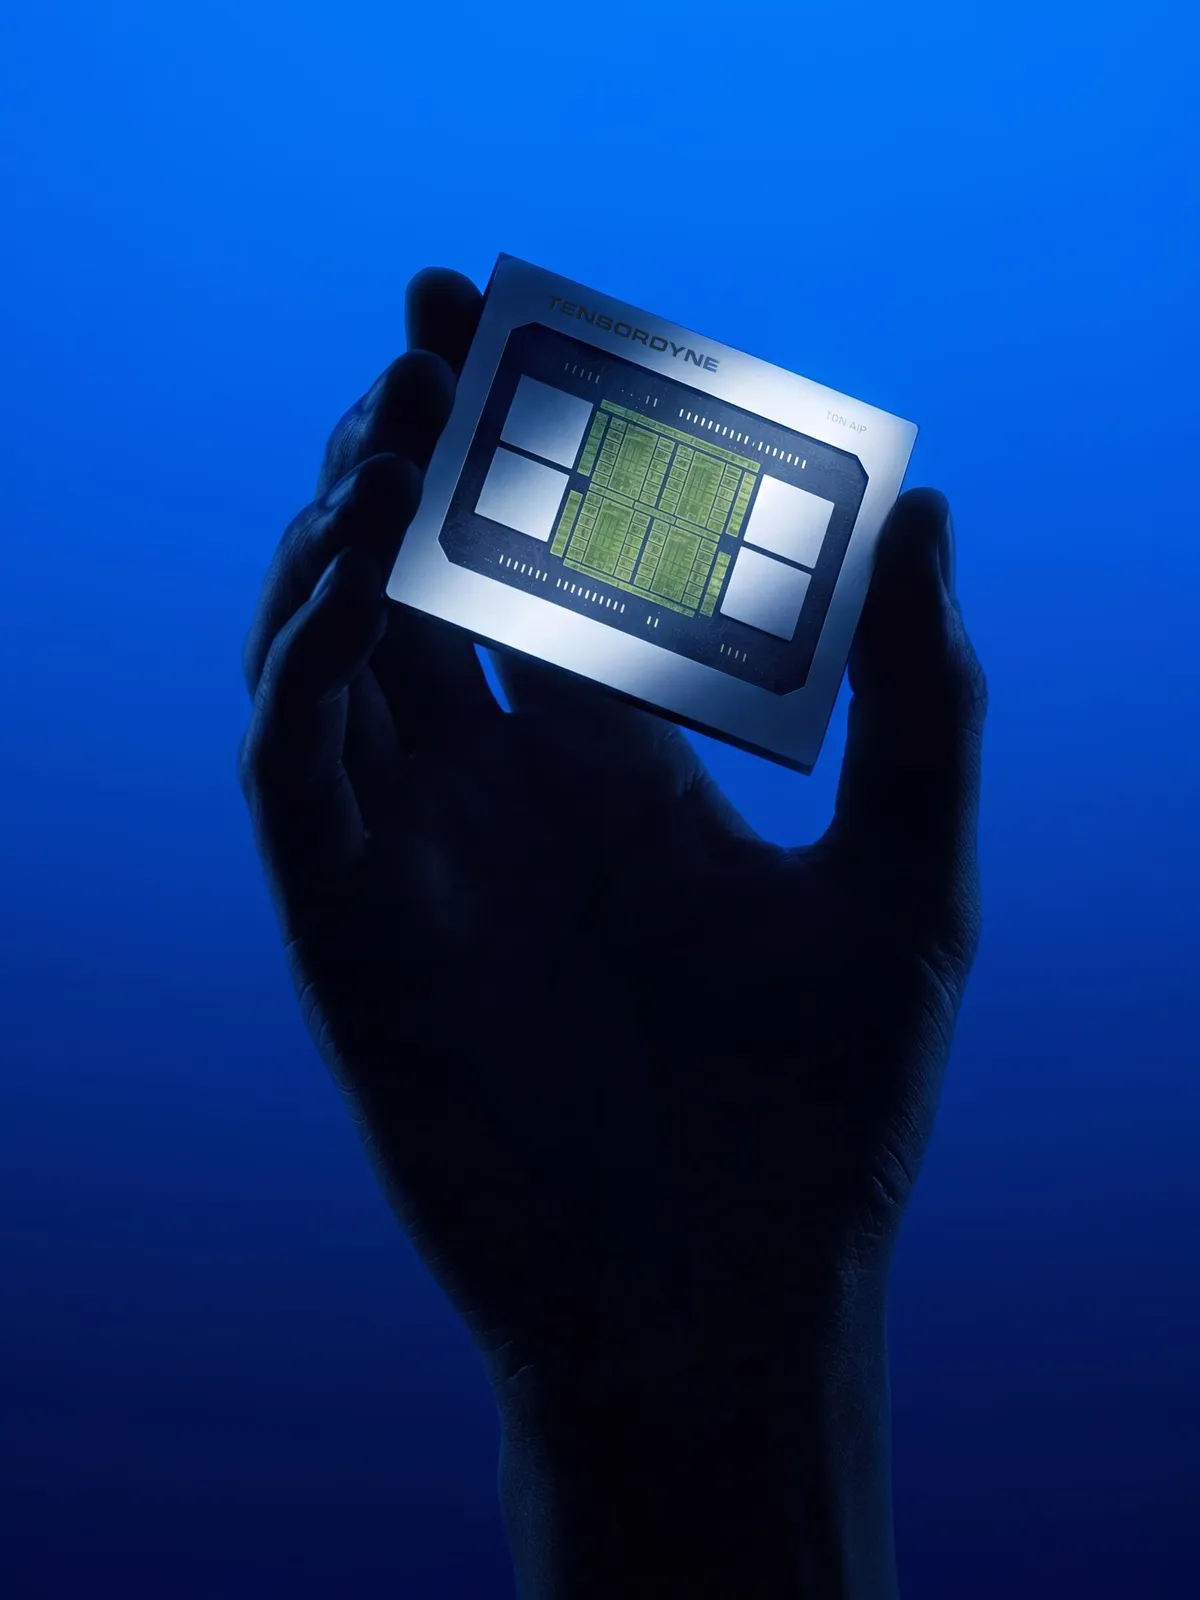 Napier — специализированный чип Tensordyne для инференса ИИ
Крупные лаборатории по-прежнему обучают всё более объёмные модели, но сама тема обучения постепенно отошла на второй план. В 2026 году в центре внимания оказался инференс — использование уже обученных моделей для генерации кода, написания текстов или создания изображений.
Для конечного пользователя инференс незаметен, но именно он стоит за каждым обращением к чат-боту, за автодополнением кода в редакторе, за генерацией картинки по текстовому описанию и за работой голосовых помощников. Каждый такой запрос — это отдельный проход обученной модели через её параметры, и чем чаще люди и сервисы обращаются к ИИ, тем больше вычислительных мощностей требуется именно на этом этапе, а не на этапе разового обучения модели.
«Обучение — это уже вчерашняя новость, — отмечает Мэтт Кимбалл, ведущий аналитик по дата-центрам исследовательской компании Moor Insights & Strategy. — Любой ИТ-директор сегодня хочет говорить только об инференсе». Глава Nvidia Дженсен Хуанг на конференции компании GTC 2026 назвал этот сдвиг «точкой перегиба инференса».
Причина сдвига довольно проста: языковые модели стали по-настоящему полезны, и ими стали активно пользоваться. К этому добавляется то, что многие современные модели — рассуждающие: в ответ на один запрос пользователя они прогоняют инференс не один раз, а несколько, последовательно переспрашивая сами себя — этот приём называют цепочкой рассуждений. Такие модели генерируют более длинные ответы, а версии с высоким уровнем «усилий по рассуждению» способны выдавать до 20 раз больше текста, чем модели с низким уровнем или вовсе без него. Нагрузку увеличивает и распространение агентного ИИ: теперь инференс работает не только как мгновенный ответ на запрос, но и круглосуточно, автономно продвигаясь к цели, заданной пользователем.
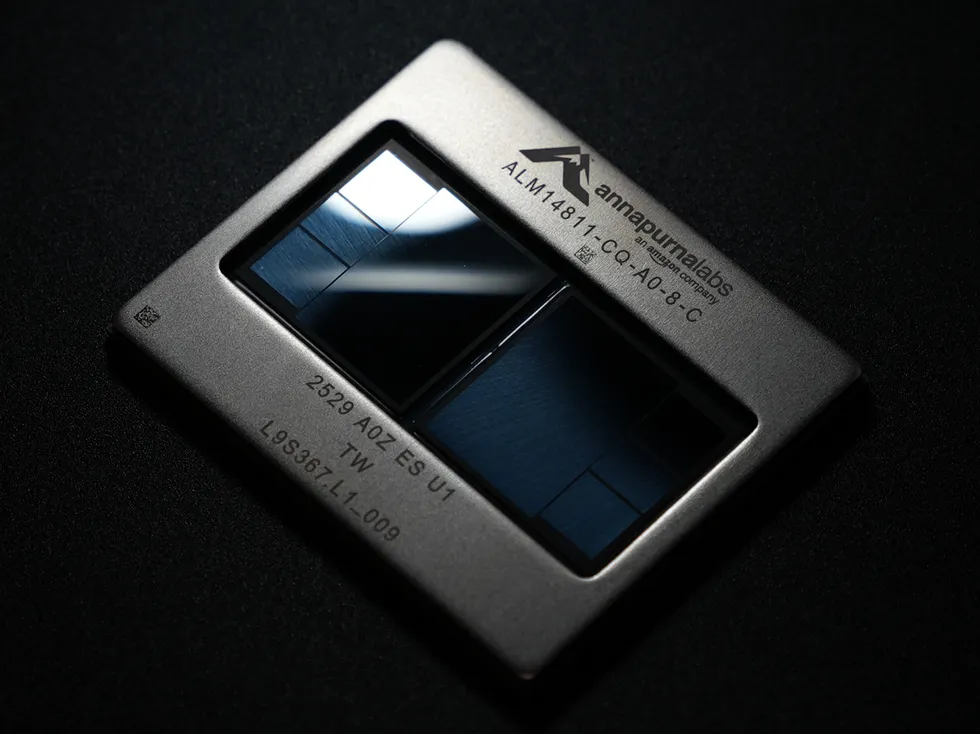 Trainium создавался для обучения ИИ, но AWS также использует его для части инференса
Взрывной рост спроса на инференс привёл к неожиданным альянсам между технологическими гигантами. OpenAI и Amazon развернули чипы размером с обеденную тарелку, разработанные компанией Cerebras, — и это притом что у Amazon есть собственные чипы Trainium. Nvidia выкупила ключевые кадры и интеллектуальную собственность у стартапа Groq, специализирующегося на инференс-чипах: сделка обошлась в 20 миллиардов долларов и вызвала немало споров. А Anthropic платит конкуренту SpaceXAI, разработчику семейства моделей Grok, более миллиарда долларов в месяц за аренду свободных вычислительных мощностей.
Хотя на первый взгляд задачи похожи, обучение и инференс ИИ вычислительно устроены по-разному. Столь масштабные шаги технологических гигантов говорят о том, что для инференса потребуется совсем иной набор оборудования, чем предполагалось ещё пару лет назад.
Чем инференс отличается от обучения
Необученную языковую модель можно сравнить с рассыпанными по столу фишками для «Эрудита»: вместо отдельных букв на них — фрагменты слов, так называемые токены. Всё необходимое для написания почти любого текста уже есть, но пока в этом наборе нет никакого смысла.
Обучение модели — это игра-угадайка, разыгранная в колоссальном масштабе. Модели показывают реальный текст со скрытым следующим токеном и просят предсказать его. После каждой догадки правильный токен открывается и сравнивается с предсказанием, а разница используется для расчёта точности модели. Партия разыгрывается не на одном предложении, а на миллиардах текстовых фрагментов.
Если настоящий «Эрудит» можно разложить за пакетом чипсов и парой напитков, то обучение ИИ — процесс исключительно ресурсоёмкий. Модель обновляет параметры методом обратного распространения ошибки — процедурой, которая снова и снова вычисляет, как должен измениться каждый из миллиардов или триллионов параметров модели, чтобы следующее предсказание стало точнее. Именно поэтому технологические гиганты строят дата-центры, каких раньше не бывало.
В какой-то момент создатель модели решает, что дальнейшее обучение того не стоит, и игра-угадайка останавливается. Обратное распространение ошибки прекращается, параметры фиксируются, и LLM становится предобученной моделью. Дообучение — короткий дополнительный прогон на меньшем, более специализированном наборе данных — вносит финальные штрихи, после чего модель отправляется в эксплуатацию.
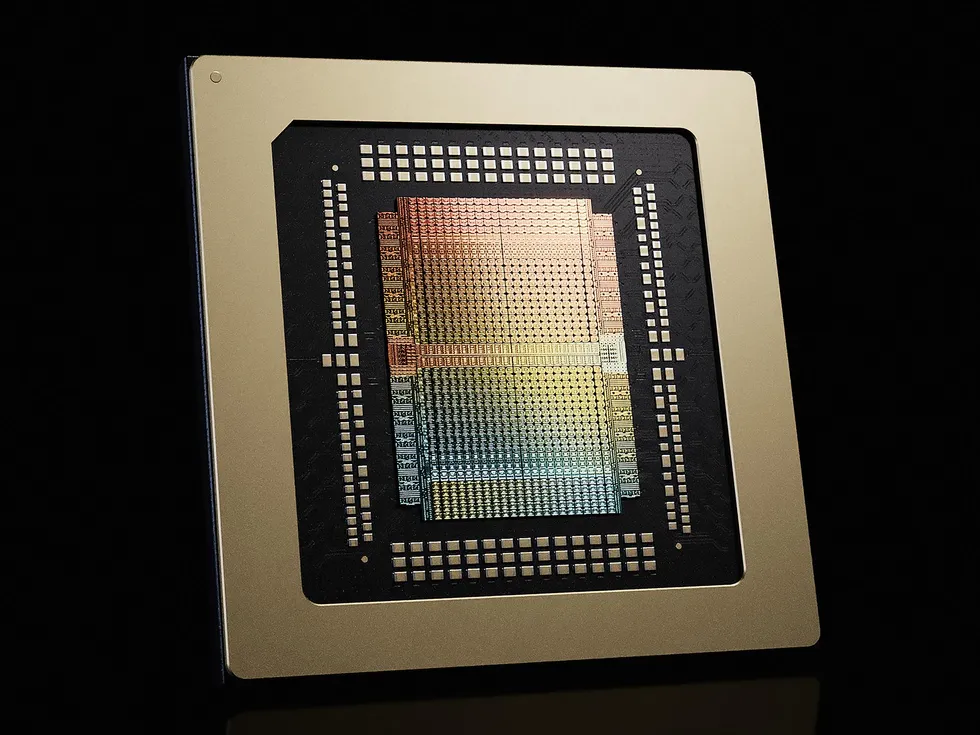 Groq 3 LPU снижает перемещение данных, размещая SRAM и вычислительные блоки прямо на кристалле
Дальше наступает черёд инференса — использования уже развёрнутой модели, которая после обучения научилась выкладывать фишки-токены в осмысленном порядке.
Можно было бы предположить, что инференс менее требователен к вычислениям, ведь расчёты обратного распространения ошибки для обновления параметров из него исключены. Но Судип Бходжа, основатель и технический директор компании d-Matrix, специализирующейся на чипах для инференса, объясняет, что здесь возникают собственные сложности.
Модели по своей природе авторегрессивны: следующий результат зависит от предыдущего. «Чтобы сгенерировать очередной токен, нужно прочитать все веса и весь контекст, накопленный с предыдущего токена», — поясняет Бходжа. Контекст включает все реплики пользователя, все ответы модели и все загруженные файлы. Это огромный объём данных и огромный объём обработки.
Языковая модель формирует ответ в две фазы: prefill (предзаполнение) и decode (декодирование). Prefill — это чтение моделью запроса целиком: она обрабатывает сразу все токены, вычисляя, как каждый из них связан со всеми остальными. Эта операция называется вниманием (attention) и составляет отличительную черту архитектуры трансформера, лежащей в основе современных LLM. Именно она позволяет модели реагировать на слово с учётом предложения, абзаца и более широкого контекста, а не изолированно. Это похоже на то, как игрок раскладывает фишки перед ходом, представляя разные их сочетания: самовнимание играет похожую роль, только вместо физических фишек каждый токен посылает запрос остальным и получает в ответ оценку своей значимости.
Эти запросы порождают два типа векторов — ключи и значения. Обычно их хранят в так называемом KV-кэше. Строго говоря, это не обязательно: модель могла бы заново вычислять эти векторы для каждого нового токена. Но почти все LLM используют KV-кэш, чтобы сократить объём вычислений. Он хранится в памяти и служит своего рода «черновиком», к которому модель обращается, чтобы не терять нить разговора; начинаясь небольшим, он может разрастись до десятков гигабайт.
Prefill — задача, которую легко разбить на части и обрабатывать параллельно. Именно поэтому графические процессоры стали доминирующим типом ускорителей ИИ по мере роста популярности LLM: растеризация графики (расчёт цвета каждого пикселя на экране) тоже массово параллельна, так что архитектура GPU подошла для этого естественным образом.
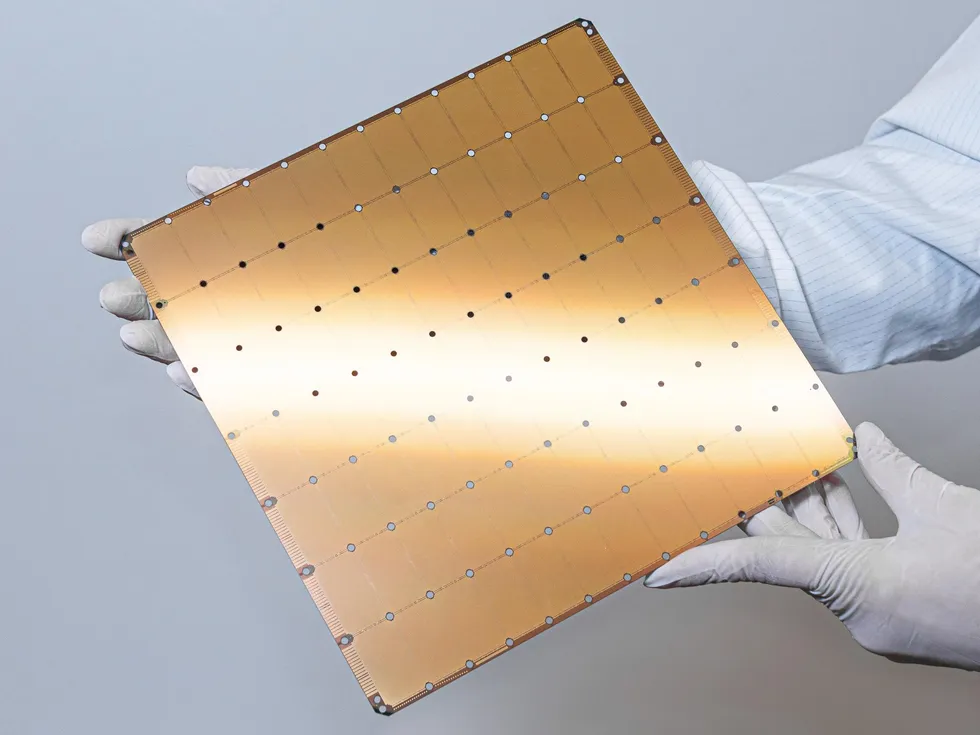 Wafer-Scale Engine от Cerebras размещает память и вычисления рядом на цельной кремниевой пластине
Дальше идёт decode: здесь модель генерирует ответ по одному токену за раз. На каждом шаге она берёт самый свежий токен, сопоставляет его со всем содержимым KV-кэша, использует эту информацию, чтобы предсказать следующий токен, и добавляет его ключ и значение в кэш. Затем цикл повторяется, токен за токеном.
Именно здесь авторегрессивная природа модели начинает работать против скорости инференса. Чтобы предсказать очередной токен, нужно прочитать из памяти всю модель — а это порой десятки и даже сотни гигабайт параметров, то есть чисел, которые описывают то, чему модель научилась. Причём это дополнительно к памяти, которая нужна для хранения KV-кэша.
В результате перемещение всех этих данных через память нередко требует большей пропускной способности, чем доступно оборудованию для инференса. Поэтому часть вычислительных блоков GPU простаивает в ожидании данных. Исследователи выяснили, что GPU Nvidia H100, обслуживающие открытые LLM, простаивают от 50 до 80% времени.
Память — главное узкое место инференса
Шахриар «Ша» Рабии, ранее возглавлявший разработку кремния в Meta*, а ныне сооснователь ИИ-стартапа Majestic Labs, говорит, что простаивающие процессоры — как раз причина, по которой многие компании, пытающиеся улучшить производительность инференса, сосредоточились именно на памяти. «При подходе на основе GPU вы получаете сильно избыточные вычислительные мощности и нехватку памяти. Именно это подталкивает к масштабированию памяти», — поясняет он.
И d-Matrix Бходжи, и Majestic Labs Рабии сосредоточены на этом узком месте, но предлагают разные решения.
Ускоритель второго поколения от d-Matrix под названием Raptor стремится повысить производительность инференса за счёт минимизации расстояния между вычислительными блоками и памятью. В большинстве современных инференс-решений на GPU память с высокой пропускной способностью (HBM) размещают по периметру чипа: каждый модуль HBM — это стопка кристаллов DRAM (динамической памяти с произвольным доступом, самого распространённого типа памяти в бытовой электронике), соединённых друг с другом и подключённых сверхбыстрым интерфейсом к GPU. Для обучения такая схема отлично подходит, но для инференса объём памяти, который удаётся уложить таким способом, и её пропускная способность оставляют желать лучшего.
Raptor от d-Matrix устраняет это узкое место, размещая ИИ-ускоритель прямо на кристалле DRAM: вместо того чтобы просто складывать модули памяти, компания складывает вместе память и вычислительные блоки. По словам Бходжи, это сокращает расстояние, которое должны преодолевать данные, «до микрометров вместо миллиметров». Как и при строительстве небоскрёба, движение вверх позволяет разместить больше на той же площади.
Majestic Labs пошла противоположным путём. Вместо того чтобы сокращать расстояние между вычислениями и памятью, компания сосредоточилась на улучшении самого интерфейса памяти, чтобы он выдерживал более длинные дорожки при сохранении высокой пропускной способности. Более длинные проводники позволяют Majestic подключать модули памяти, которые физически не примыкают к GPU, снимая пространственное ограничение, свойственное HBM.
«У интерфейса памяти очень небольшое физическое расстояние, на котором он вообще способен работать. В случае HBM это 2–3 миллиметра — узкая «береговая линия» по периметру чипа, единственное место, куда вообще можно поставить HBM», — говорит Рабии.
По утверждению Majestic, её интерфейс памяти способен передавать данные на расстояние около метра. Это достигается за счёт фирменной медной линии связи и чипа-агрегатора памяти, координирующего данные. «Агрегатор — это конечная точка высокоскоростного интерфейса и способ развести сигнал на множество обычных чипов DRAM», — говорит Рабии. Благодаря этому Majestic способна поддерживать до 128 терабайт памяти DRAM в одной серверной стойке — заметно больше, чем около 20 терабайт памяти HBM3E в стойке Nvidia GB300 NVL72.
У d-Matrix и Majestic есть одна общая черта: вместо HBM обе компании используют обычную, массовую память DRAM — самый распространённый тип памяти в мире, встречающийся в смартфонах и автомобилях. По словам аналитика рынка памяти Джима Хэнди, HBM стоит в два-три раза дороже DRAM, и именно ценовое преимущество отчасти определило выбор d-Matrix и Majestic. Впрочем, сторонники HBM — а среди них такие гиганты памяти, как Samsung и SK Hynix, — тоже не сидят сложа руки.
HBM4, новейшая версия памяти HBM, уже запущена в производство и будет использоваться в GPU Nvidia Vera Rubin, выход которого ожидается во второй половине 2026 года. Хошик Ким, руководитель направления исследований систем памяти в SK Hynix, говорит, что HBM4 «решительно снимет ограничения по памяти, сдерживающие инференс ИИ сегодня», удвоив максимальную пропускную способность HBM и увеличив объём памяти на один модуль.
Как разные чипы комбинируют ради ускорения инференса
Крупные игроки — Nvidia и Amazon — выбрали подход «в ход идут все чипы разом». GPU Nvidia и обучающие ускорители Trainium от Amazon по-прежнему отлично справляются с частью работы по инференсу — фазой prefill, где рассчитываются все ключи и значения контекста. А вот для ускорения decode, где генерируются новые токены, они обращаются к новым, ориентированным на память архитектурам от менее крупных игроков.
В случае Nvidia таким игроком стала компания Groq (не путать с Grok — семейством моделей от SpaceXAI). Nvidia выкупила интеллектуальную собственность и наняла специалистов Groq в конце 2025 года, а спустя всего три месяца, на конференции GTC 2026, Дженсен Хуанг представил языковой процессор Nvidia Groq 3 LPU. Архитектура Groq опирается на память — в данном случае статическую SRAM, — встроенную прямо в кристалл чипа.
Если вы не проектируете чипы и не увлекаетесь играми на мощном ПК, о памяти SRAM вы, вероятно, никогда не задумывались. У SRAM есть преимущество — она тесно интегрирована в архитектуру вычислительного чипа, находясь на одном кристалле с процессором, — и недостаток: она менее плотная и более дорогая, чем DRAM. В большинстве чипов таких блоков лишь несколько десятков мегабайт. Но инференс ИИ разжёг новый интерес к SRAM как способу приблизить веса модели, хранящиеся в памяти, к вычислительным блокам.
Иэн Бак, вице-президент и генеральный менеджер направления гипермасштабируемых и высокопроизводительных вычислений в Nvidia, говорит, что у LPU совсем другой набор приоритетов, чем у GPU компании. У LPU куда меньше «сырой» вычислительной мощности, чем у стандартного GPU, зато он получает 500 мегабайт SRAM прямо на кристалле, подключённой напрямую к блокам вычислений с плавающей запятой. «Выгода — в пропускной способности памяти: у LPU она в семь раз выше, чем у GPU», — говорит он.
В теории связка из GPU Rubin и LPU Groq позволяет ускорить и prefill, и decode, получив лучшее из обоих миров. «Всю математику внимания и обработку контекста мы выполняем на стойке Vera Rubin, — поясняет Бак. — А все вычисления «экспертов»… матричные умножения — на LPU». В систему Groq 3 LPX, по размеру сопоставимую со стойкой дата-центра, компания упаковывает 256 таких LPU.
Amazon Web Services (AWS), в свою очередь, заключила сделку с Cerebras, объединив ускоритель Trainium с чипом Wafer-Scale Engine 3 (WSE-3). Cerebras использует подход, схожий с Groq, но в куда большем масштабе: WSE-3 превращает целую кремниевую пластину в единый чип, содержащий свыше 4 триллионов транзисторов. Такая конструкция не подключается к внешней памяти, а вытравливает на пластине 44 гигабайта SRAM. «Мы храним веса модели прямо в SRAM, — говорит Джеймс Ван, ранее директор по продуктовому маркетингу Cerebras, а ныне сотрудник SpaceXAI. — Это позволяет разместить на одном чипе от 40 до 80 миллиардов параметров».
Amazon планирует использовать чипы AWS Trainium для prefill, а Cerebras — для decode. Но чипы Cerebras способны справляться с инференсом и в одиночку: WSE-3 был задействован OpenAI для работы GPT-5.3-Codex-Spark — варианта модели для программирования, выдающего свыше 1000 токенов в секунду. Для сравнения, стандартное развёртывание GPT-5.4 выдаёт от 50 до 125 токенов в секунду.
Cerebras способна взять на себя и prefill без переноса нагрузки на другие специализированные чипы: для этого несколько чипов WSE-3 объединяют в сети в единый пул памяти. Компания продемонстрировала, что таким образом можно обслуживать модели объёмом до 1 триллиона параметров, включая Kimi 2.6 от Moonshot AI, хотя, по словам Вана, «у архитектуры нет принципиального ограничения по числу параметров, с которым она способна работать».
Несмотря на разницу в стратегиях, Nvidia и AWS сходятся во мнении, что будущее инференса ИИ — за системным подходом, который объединяет разные типы чипов ради обслуживания крупнейших языковых моделей.
«Чтобы делать современный ИИ-инференс, нужны все чипы сразу» — так эту мысль формулирует Иэн Бак из Nvidia.
Если свести эти подходы воедино, получится, что одна и та же проблема решается четырьмя разными способами:
- d-Matrix — складывает вычислительные блоки прямо на кристалл DRAM, сокращая расстояние до микрометров.
- Majestic Labs — удлиняет интерфейс памяти, чтобы подключать модули DRAM в стороне от GPU.
- Groq и Cerebras — встраивают SRAM прямо в кристалл или пластину, жертвуя гибкостью ради скорости.
- Nvidia и AWS — комбинируют разные типы чипов для prefill и decode в рамках одной системы.
Меньше битов — выше эффективность
Nvidia стала самой дорогой технологической компанией в мире благодаря самым востребованным на рынке GPU. Но повышение производительности инференс-оборудования — не единственный путь: исследователи ИИ также учатся совместно оптимизировать программное обеспечение и «железо» LLM, чтобы эффективнее использовать память и вычислительные ресурсы.
Большинство компьютеров хранят числа в 32- или 64-битном формате — это определяет, сколько бит доступно для представления одного числа. Если бит слишком мало, число невозможно сохранить без потери информации. Качество LLM выигрывает от более точных числовых форматов, но это создаёт проблему для производительности инференса: более точные числа не бесплатны — биты, которые их описывают, занимают больше места в памяти и требуют больше кремния и энергии для вычислений.
Жиль Бакхус, сооснователь компании-разработчика ИИ-ускорителей Tensordyne, говорит, что здесь возникает противоречие между размером модели и точностью чисел. «Что вы предпочтёте: модель размера X, работающую в 8-битном формате, или модель вдвое большего размера, работающую в 4-битном?» По объёму памяти и вычислений оба варианта примерно равны, «но подход с 4 битами даёт, условно говоря, вдвое больше «синапсов». И индустрия начинает понимать, что оно того стоит».
Перевод LLM из более точного числового формата в менее точный называется квантованием и применяется уже не первый год. Но исследователи находят всё новые способы снижать точность моделей, сохраняя при этом большую часть их качества.
Недавно Nvidia создала новый 4-битный числовой формат NVFP4. AMD, Intel и Qualcomm вместо этого сплотились вокруг конкурирующего 4-битного формата MXFP4, в разработке которого, впрочем, тоже участвовала Nvidia. «Это настоящее чёрное искусство ИИ», — говорит Бак из Nvidia. По данным компании, при переводе модели DeepSeek-R1 из формата FP8 в NVFP4 результаты по семи ключевым тестам просели менее чем на 1%, а производительность выросла втрое.
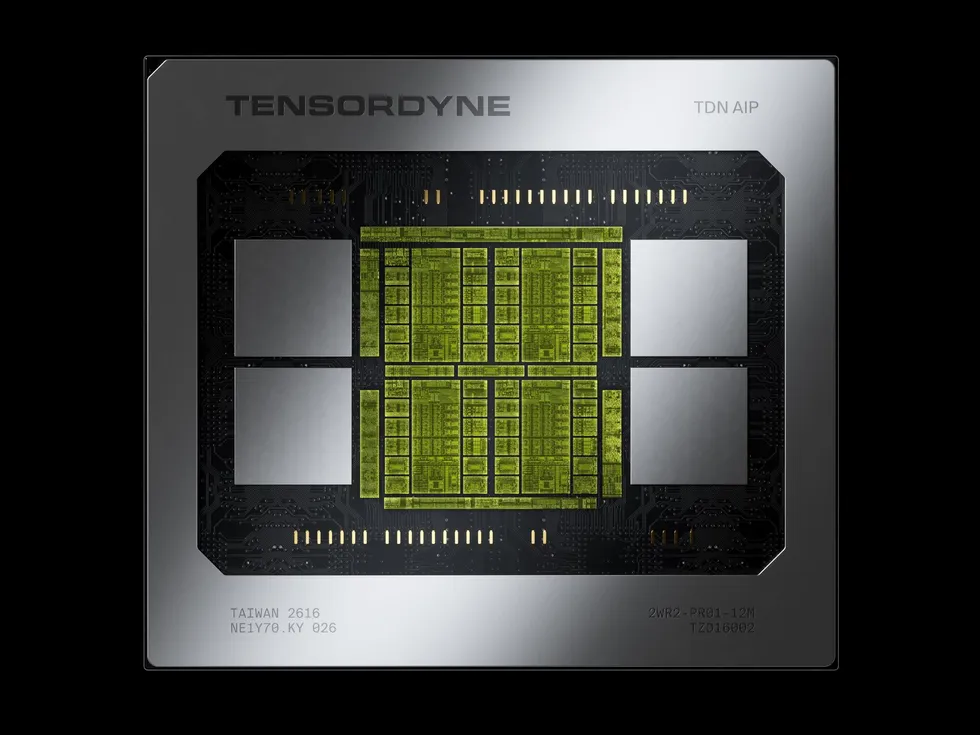 В Napier логарифмический формат чисел сочетается с заказной архитектурой Tensordyne
Квантование — вероятно, лишь верхушка айсберга: исследователи и стартапы изучают самые разные направления оптимизации, некоторые из которых способны радикально изменить кремний, лежащий в основе инференс-оборудования.
Выгода от таких решений не сводится к чистой скорости ответа. Каждый ватт, сэкономленный на передаче данных между памятью и вычислительными блоками, снижает энергопотребление дата-центра и, соответственно, стоимость одного запроса к модели. Именно поэтому инвесторы и облачные провайдеры внимательно следят не только за «сырой» производительностью новых чипов, но и за их энергоэффективностью на токен — метрикой, которая напрямую влияет на то, сколько будет стоить подписка на ИИ-сервис для конечного пользователя.
Tensordyne рассчитывает ускорить инференс с помощью логарифмической системы счисления, опирающейся на свойство логарифмов: логарифм произведения A и B равен сумме логарифмов A и B. Иначе говоря, если хранить числа в виде их показателей степени, чип может складывать там, где иначе пришлось бы умножать, — а умножающие схемы в кремнии потребляют больше энергии и занимают больше площади кристалла, чем сумматоры. По словам компании, её оборудование стоечного масштаба под названием Napier способно выдавать до 1300 токенов в секунду на пользователя, расходуя при этом менее десятой доли энергии по сравнению с сопоставимым оборудованием Nvidia.
Стартап Etched из Сан-Хосе пошёл ещё дальше: он проектирует ИИ-ускорители, которые переносят саму архитектуру трансформера, лежащую в основе LLM, напрямую в кремний. Вместо универсальных GPU компания «зашивает» в чип связи, нужные именно для эффективных расчётов трансформера, — это делает чип куда менее гибким, зато более эффективным для задач, которые чаще всего решают современные LLM. По данным компании, её первый ИИ-ускоритель Sohu способен обеспечивать инференс модели Llama 70B от Meta на скорости до 500 000 токенов в секунду, хотя такой подход также означает, что чип не сможет работать с LLM, отходящими от типичной архитектуры трансформера.
Оправдаются ли эти идеи, пока не известно. Etched отгрузила свою первую стойку в августе 2026 года. Tensordyne рассчитывает, что её первое оборудование появится на рынке в 2027 году. Но даже сейчас эти стартапы показывают, как спрос на производительность инференса подпитывает самые нестандартные идеи.
Инференс — игра для всех
Такое разнообразие подходов к ускорению инференса ИИ — от размещения вычислений на памяти и удлинения интерфейсов с миллиметров до метров до превращения целой кремниевой пластины в SRAM и «сжатия» моделей до 4 бит — напрашивается на вопрос: какой из них победит, а какой проиграет?
Но, по мнению экспертов, вопрос, скорее всего, поставлен неверно. Спрос на ИИ сейчас практически ненасытен, и хотя опасения по поводу «пузыря» ИИ преследуют индустрию, пока они не затормозили рост.
Кимбалл из Moor Insights & Strategy, напротив, считает, что в долгосрочной перспективе именно инференс может обеспечить колоссальный спрос на ИИ-оборудование — просто потому, что неясно, где предел этому спросу. «Вы можете добавить в организацию миллион агентов, — говорит он. — Они работают круглые сутки: в отличие от нас, не расходятся домой в пять вечера».
Если спрос на инференс ИИ останется таким же высоким, как ожидает Кимбалл, его эволюция, вероятно, повторит траекторию развития обычного процессора. CPU совершенствовался не по одной оси, а сразу по нескольким направлениям: как только масштабирование транзисторов замедлилось, начали множиться самые разные архитектурные новшества на уровне чипов и систем. Список отдельных изобретений, которые в итоге привели к сегодняшним повсеместным и мощным персональным компьютерам, занял бы не один десяток книг.
Для рынка это означает, что ни один из описанных подходов не обязан стать единственным победителем. Дата-центры, скорее всего, будут одновременно использовать GPU для одних задач, специализированные LPU и вафельные чипы — для других, а память DRAM и HBM продолжат сосуществовать, каждая в своей нише. Победителем в такой гонке окажется не конкретная архитектура, а конечный пользователь, который получит более быстрые и дешёвые ответы от нейросетей.
Спустя несколько десятилетий история инноваций в области инференса ИИ, судя по всему, окажется не менее насыщенной.
* Принадлежит компании Meta, деятельность которой признана экстремистской и запрещена на территории Российской Федерации. Социальные сети Facebook и Instagram запрещены в РФ.