Причин запускать большие языковые модели (LLM) локально хватает — от заботы о приватности до простого желания поэкспериментировать. Стандартная логика гласит: для действительно крупных моделей нужны большие деньги и очень много видеопамяти. Один энтузиаст решил оспорить это утверждение.
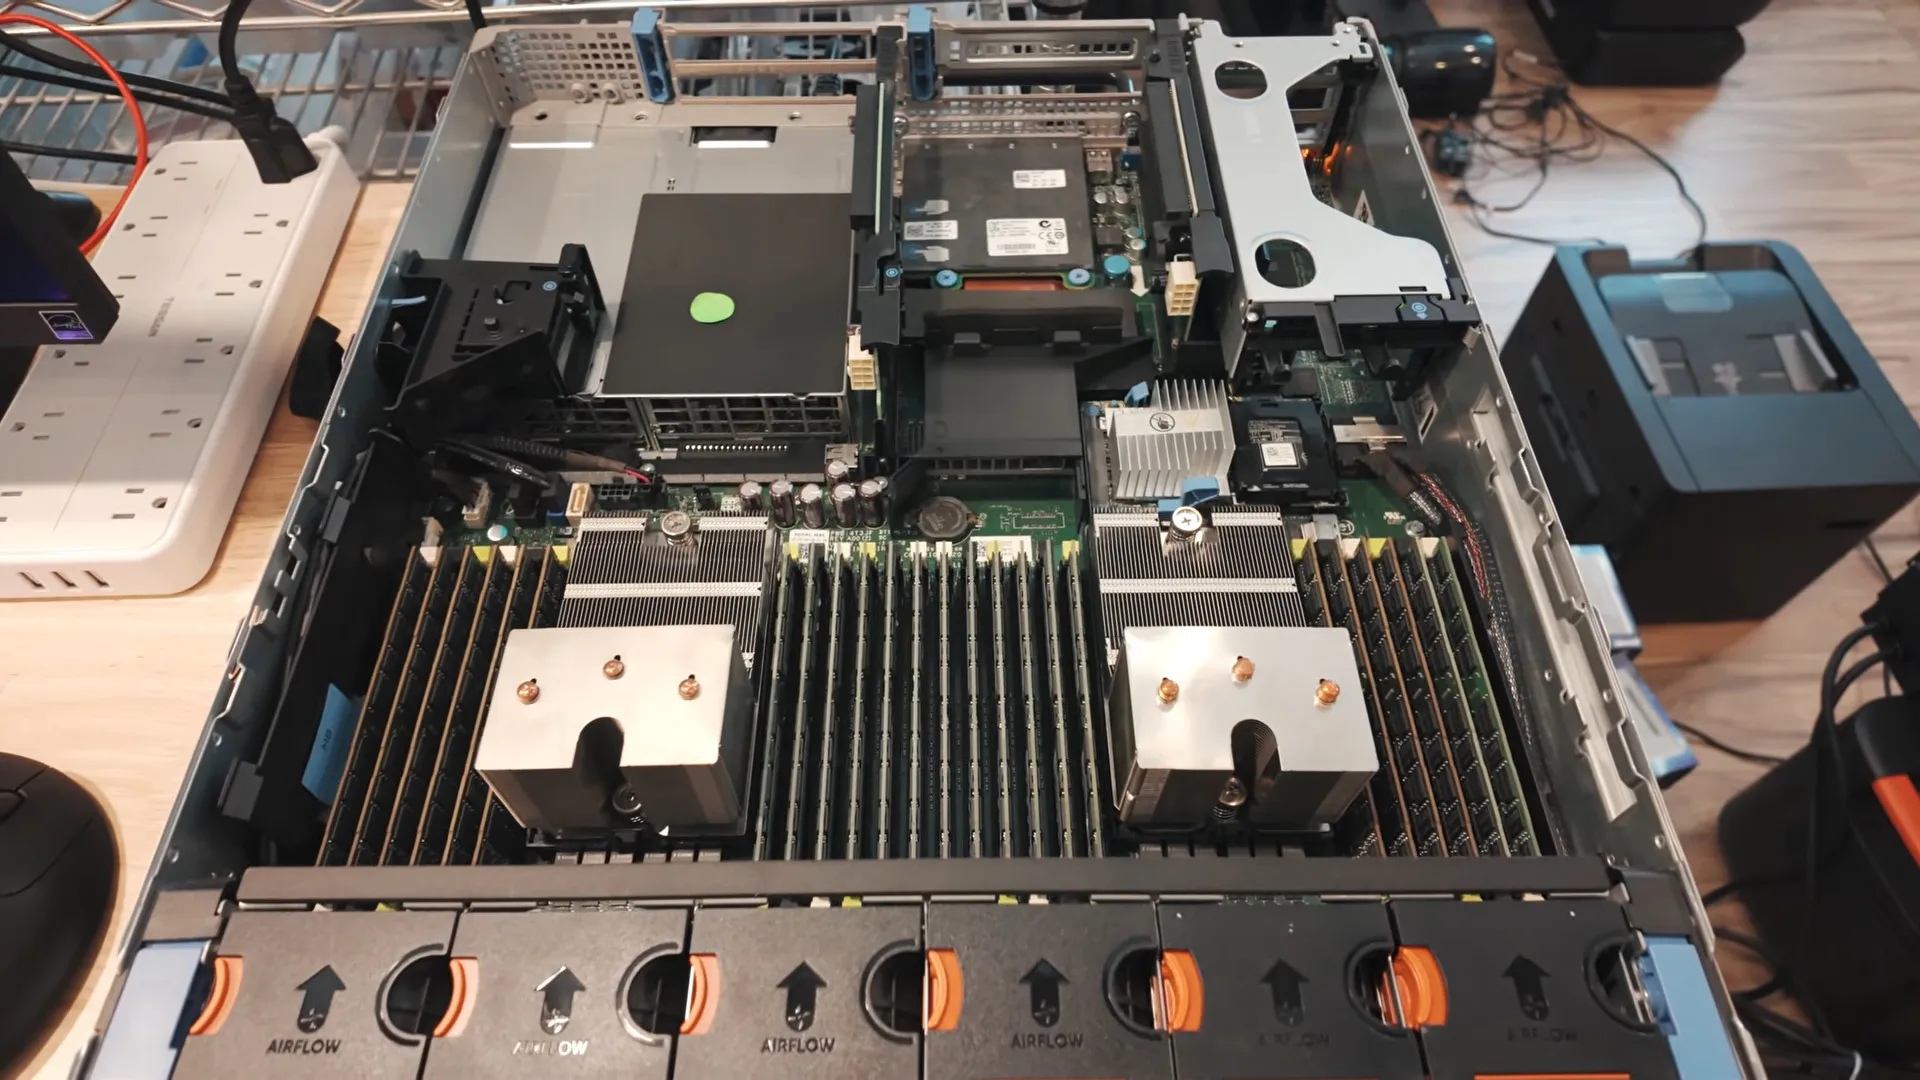
В своём эксперименте он запустил флагманские модели GLM и Qwen на 14-летнем сервере вообще без единой видеокарты. Секрет — в оперативной памяти: модели целиком помещаются в 348 ГБ DDR3 системной памяти сервера Dell PowerEdge R720 с двумя процессорами Xeon.
Расплата за такой подход — скорость. Потолок составил около 4 токенов в секунду: сказывается всего 20 доступных потоков на два процессора и отсутствие у старых Xeon некоторых инструкций, которые могли бы ускорить вычисления. О разговоре с ИИ в реальном времени речи не идёт.
И всё же это не просто трюк ради трюка. Есть задачи пакетной обработки, где 4 токена в секунду вполне приемлемы, а подобные серверы у многих энтузиастов уже простаивают в домашних лабораториях. Если такой сервер есть и у вас — эксперимент вполне стоит повторить.
Если же покупать железо специально, то и это не разорительно: на вторичном рынке подобная конфигурация обходится примерно в $600. Автор отмечает, что новые модели ещё могут получить оптимизации и прибавить в скорости. В любом случае для локальных LLM это несравнимо лучше, чем игрушечные модели на совсем древнем железе.