25 августа 2026 года компания OpenAI полностью раскрыла подробности о Jalapeño — своём первом собственном ускорителе для задач искусственного интеллекта. Впервые чип вместе с партнёром по разработке, компанией Broadcom, показали ещё 24 июня 2026 года, а в конце августа OpenAI опубликовала развёрнутые характеристики и результаты тестов. Jalapeño обеспечивает до 13,4 петафлопса вычислительной производительности в 4-битном формате и работает с 232 ГБ (216 ГиБ) самой передовой из доступных памяти, обмениваясь с ней данными на скорости 15,4 терабайта в секунду.
Петафлоп — единица производительности, равная квадриллиону операций с плавающей запятой в секунду. Уточнение про 4-битные вычисления принципиально: при инференсе, то есть при работе уже обученной модели, веса и промежуточные данные всё чаще хранят в сжатых форматах разрядностью 4 бита. Это экономит память и нагрузку на шину, а при грамотной квантизации качество ответов почти не страдает. Для больших языковых моделей узким местом нередко становится не сама арифметика, а скорость доставки данных из памяти, поэтому пропускная способность памяти для такого чипа не менее важна, чем число операций в секунду.
Согласно бенчмаркам, на которые ссылается OpenAI, Jalapeño сокращает сквозную задержку — время от отправки запроса до генерации последнего токена ответа — до 3,6 раза по сравнению с Nvidia GB300, на которую компания опирается в своей инфраструктуре, и при этом потребляет меньше энергии. В опубликованных OpenAI сравнениях со стоечными системами Nvidia GB200 и GB300 выигрыш по задержке составил от 1,7 до 3,6 раза, а по пропускной способности в пересчёте на киловатт — от 1,5 до 1,9 раза.
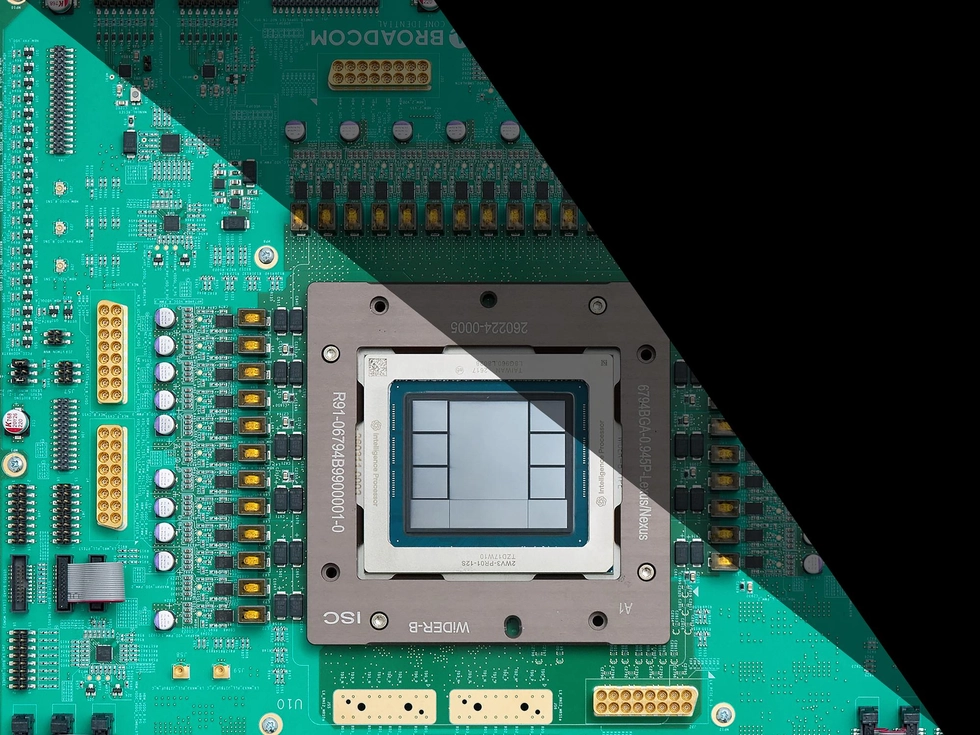 Jalapeño объединяет вычислительный кристалл с шестью стеками памяти HBM4 и чиплетом ввода-вывода. Источник изображения — spectrum.ieee.org
Память в корпусе Jalapeño организована в виде шести стеков HBM4. High Bandwidth Memory — это многослойная DRAM: несколько кристаллов памяти укладываются друг на друга, соединяются сквозными вертикальными межсоединениями (TSV) и размещаются в одном корпусе рядом с процессором. Короткие линии связи позволяют прокачивать огромные объёмы данных при умеренном энергопотреблении, поэтому HBM стала стандартом для ИИ-ускорителей. HBM4 — четвёртое поколение технологии; по данным аналитиков TrendForce, память для Jalapeño предположительно поставляет Samsung. Отдельный чиплет ввода-вывода — небольшой самостоятельный кристалл в том же корпусе — отвечает за внешние интерфейсы, и эти блоки не приходится размещать на основном вычислительном кристалле.
Подтвердятся ли заявленные показатели в реальной работе, станет ясно, когда Jalapeño массово появится в инфраструктуре OpenAI для инференса: первые развёртывания компании нацелены на конец 2026 года. Но производительность — лишь половина истории. Вторая половина — то, как чип проектировали: процесс заметно ускорили собственные большие языковые модели (LLM) OpenAI. Путь от первой архитектурной концепции до первого кремния занял менее 20 месяцев, а между появлением первого RTL-кода и тейпаутом прошло всего девять месяцев.
RTL (register-transfer level, уровень регистровых передач) — это описание логики чипа: какие данные хранятся в регистрах и как они преобразуются между тактами. Тейпаут — момент, когда законченный проект передаётся на фабрику для производства. Всё, что лежит между этими точками, — написание и отладка логики, верификация, синтез и физическая реализация — традиционно считается одним из самых долгих и дорогих этапов разработки микросхемы.
Сроки впечатляющие, однако эксперты полагают, что вскоре они могут показаться медленными — по мере того как LLM будут совершенствоваться и глубже встраиваться в инструменты проектирования микросхем. В OpenAI, что неудивительно, смотрят на эти перспективы с большим оптимизмом.
«Модели дают нашим инженерам сверхспособности. Работу по-прежнему ведут инженеры, последнее слово остаётся за ними. Но они могут действовать гораздо быстрее и исследовать намного больше вариантов», — говорит Ричард Хо, вице-президент OpenAI по аппаратному обеспечению.
Небольшая команда и разделение труда с Broadcom
По словам Хо, над Jalapeño в среднем работали менее 100 человек, и на сентябрь 2026 года команда насчитывает примерно столько же — теперь она занимается вторым и третьим поколениями чипа. В это число входят самые разные специалисты аппаратного подразделения — от системных архитекторов до разработчиков ПО и сотрудников, отвечающих за цепочку поставок, но не инженеры Broadcom, которая стала партнёром OpenAI в этом проекте.
Сотрудничество компаний было официально объявлено 13 октября 2025 года: OpenAI и Broadcom договорились развернуть спроектированные OpenAI ускорители суммарной мощностью 10 ГВт. Стойки с этими ускорителями и сетевым оборудованием Broadcom на базе Ethernet планировалось начать устанавливать во второй половине 2026 года, а завершить развёртывание — к концу 2029 года.
Обязанности в проекте разделили по принципу «проектирование — реализация». OpenAI отвечала за системный дизайн целиком: сам ускоритель для инференса, иерархию памяти и сетевую часть. Broadcom взяла на себя, по выражению Хо, «физическое проектирование начиная с логических вентилей» — то есть превращение описанной логики в реальную топологию кристалла, пригодную для производства.
Участие Broadcom несколько охладило оценки скорости OpenAI. Дэвид Чин, сооснователь стартапа Verkor.io, который разрабатывает агентные системы для проектирования чипов, считает представленный график вполне правдоподобным, но уверен, что без помощи Broadcom уложиться в такие сроки было бы нельзя. «Если бы кто-то другой начинал с нуля, это было бы невозможно», — отмечает он. Другой сооснователь Verkor.io, Рави Кришна, назвал результат OpenAI «относительно впечатляющим», но добавил, что с учётом прогресса языковых моделей проект, начатый в сентябре 2026 года, мог бы уложиться в ещё более сжатые сроки.
Эндрю Канг, заслуженный профессор Калифорнийского университета в Сан-Диего и руководитель открытого проекта OpenROAD по автоматизации физического проектирования микросхем, тоже считает скорость OpenAI примечательной — по его словам, это, «вероятно, лучший в своём классе результат на данный момент». Канг вспоминает семинар IEEE Design Automation Futures 2016 года, одним из организаторов которого он был. С основным докладом там выступал Ричард Хо, в то время инженер Google. Уже тогда у Хо были твёрдые взгляды на автоматизацию проектирования: время создания чипа он описывал как функцию от того, сколько итераций команда способна пройти за один день. По сути, работа над Jalapeño стала проверкой этого тезиса на практике.
Как языковые модели ускорили разработку Jalapeño
«Автоматизация в проектировании микросхем существует уже много десятилетий. Это не новая задача», — говорит Анкур Шривастава, директор по полупроводниковым инициативам и инновациям Мэрилендского университета. Отличие LLM от прежних средств автоматизации, по его словам, в том, что они понимают естественный язык и программный код. Поэтому модели особенно хорошо подходят для тех этапов разработки, которые «всё ещё находятся в языковой плоскости задачи».
Классические средства автоматизации проектирования электроники (EDA), которые выпускают, например, Synopsys, Cadence и Siemens EDA, построены прежде всего на алгоритмах оптимизации: они размещают элементы, прокладывают соединения, проверяют временные характеристики. Языковые модели же сильны там, где инженер пишет и читает текст, — в спецификациях, коде описания логики и тестах.
Команда OpenAI выстроила рабочий процесс именно вокруг этой сильной стороны. Фронтенд-разработка Jalapeño велась на основе XLS (Accelerated Hardware Synthesis) — открытого набора инструментов высокоуровневого синтеза, изначально созданного в Google. Высокоуровневый синтез позволяет инженеру описывать поведение будущей схемы в привычной программной среде, а не расписывать вручную каждый регистр. В XLS разработчики пишут на DSLX — предметно-ориентированном языке, вдохновлённом Rust, — или на C++, а инструменты затем переводят этот код в Verilog. Этот язык описания аппаратуры появился ещё в 1980-х годах, позже был стандартизирован IEEE и остаётся одним из основных в индустрии, но код на нём гораздо ближе к описанию электронной схемы, чем к обычной программе.
«Мы думали, как с помощью ИИ ускорить проект, и ИИ гораздо лучше справлялся с тем, что выглядит как программное обеспечение. XLS в некотором смысле похож на ПО, поэтому и получил это преимущество», — рассказывает Крис Лири, технический специалист OpenAI.
Помогло и то, что Лири досконально знает, как должен работать XLS: он сам запустил этот проект, когда работал в Google. Эндрю Канг согласен, что применять ИИ для ускорения высокоуровневого синтеза вроде XLS разумно: с таким кодом языковой модели «работать естественнее», а сам подход позволяет быстро проходить итерации. «Я считаю такой рабочий процесс полезным в целом, и у него есть будущее», — говорит профессор.
Та же логика подтолкнула команду Jalapeño сделать ставку на оптимизацию программного обеспечения. Когда в мае 2026 года с фабрики пришли первые чипы, инженеры поручили внутренним ИИ-моделям OpenAI писать софт для прогона бенчмарков, в том числе InferenceX аналитической компании SemiAnalysis. В тесте ядра multi-head latent attention от DeepSeek производительность примерно за 40 часов выросла с 0,31% теоретического потолка до 88,94%. Потолок при этом задаётся вычислительной мощностью чипа и пропускной способностью его памяти.
Механизм multi-head latent attention (MLA, многоголовое латентное внимание) китайская компания DeepSeek представила в 2024 году вместе с моделью DeepSeek-V2. Он сжимает кэш ключей и значений в компактное латентное представление и тем самым снижает требования к памяти при генерации длинных ответов. Ядро — это низкоуровневая программа, выполняющая такую операцию непосредственно на ускорителе, и от качества её оптимизации напрямую зависит, насколько полно модель использует возможности железа.
По словам Хо, этот результат воспроизводим, а значит, время между получением первых чипов с фабрики и выходом на серийное производство можно сократить. «Все наши предположения о графиках теперь будут строиться на том, что у нас есть такая возможность», — говорит он.
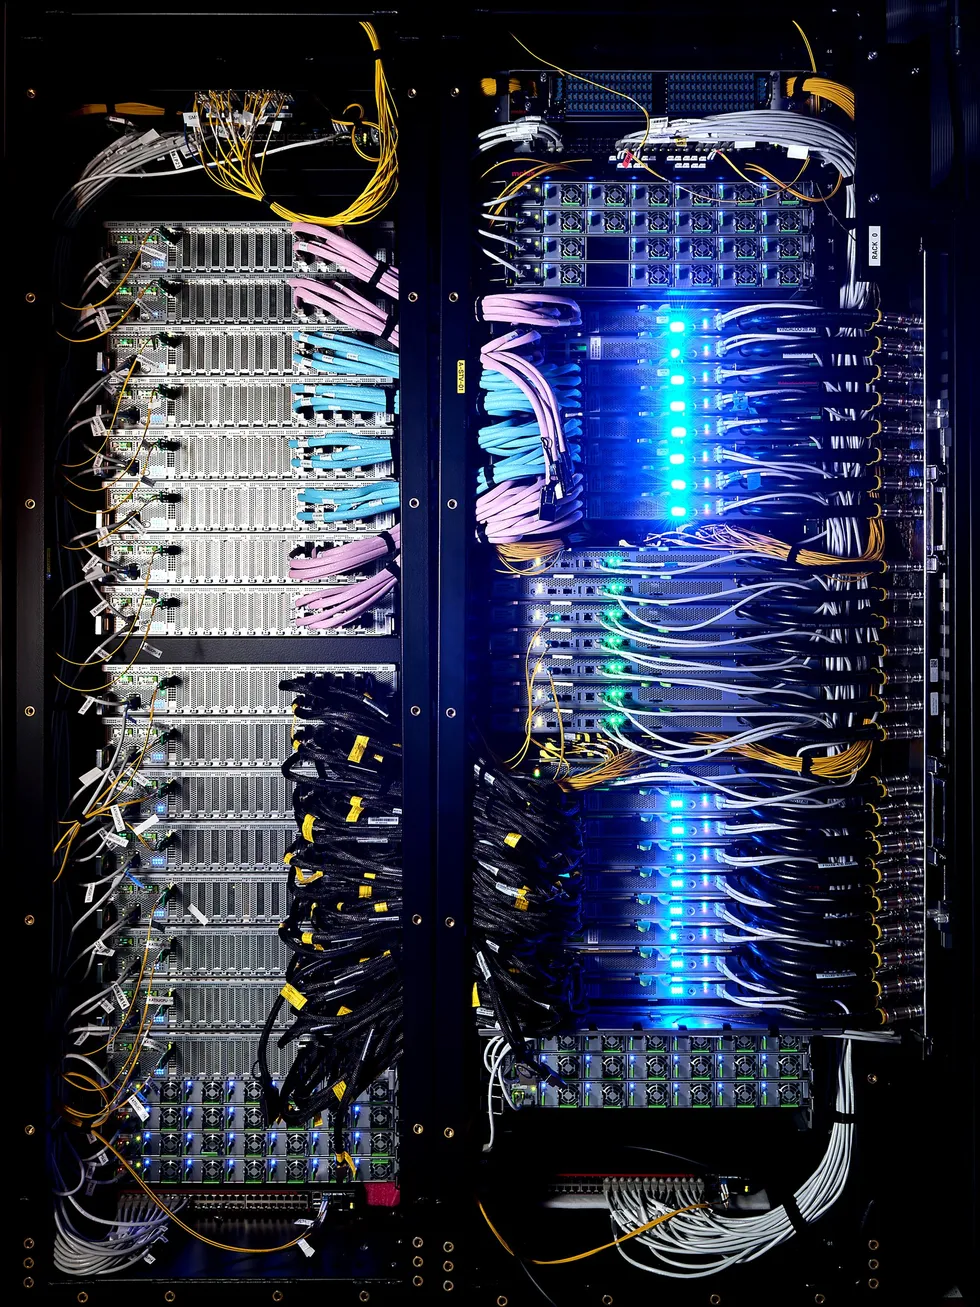 Jalapeño рассчитан на развёртывание в подах из 2048 чипов. Источник изображения — spectrum.ieee.org
Jalapeño рассчитан на работу в подах из 2048 чипов. Под — это кластер ускорителей, связанных высокоскоростной сетью и работающих как единая система: крупные модели не помещаются в память одного чипа, поэтому их веса и вычисления распределяются между множеством ускорителей.
Общие контуры рабочего процесса с опорой на ИИ Хо и Лири наметили заранее, но прогресс моделей OpenAI всё же преподнёс несколько сюрпризов. По словам Лири, в начале проекта команде помогали модели вроде o3, которая стала общедоступной в апреле 2025 года (разработчики Jalapeño получили к ней доступ раньше). А к завершению работ у команды уже были предшественники GPT-6 Astra — эта модель вышла публично только 3 сентября 2026 года. Новая модель умеет работать напрямую с Verilog, не нуждаясь в XLS для перевода кода с обычных языков программирования, и, как говорит Лири, уже близка к тому, чтобы самостоятельно управлять проприетарными инструментами проектирования.
Хо также подтвердил, что у команды был доступ к внутренним LLM, дообученным специально для проектирования микросхем и недоступным публично. Какие именно модели использовались, он не уточнил, но отметил, что команда Jalapeño работала в связке с исследовательским подразделением OpenAI. Цель — перенести опыт проекта в коммерческие модели компании. «Можно с уверенностью сказать, что Astra и последующие модели будут очень хороши в проектировании чипов», — заявил Хо.
В бэкенде ИИ пока помог меньше, но это может измениться
Основная часть работы OpenAI над Jalapeño пришлась на так называемый фронтенд проектирования. Он охватывает путь от первоначальной концепции через написание RTL-кода, задающего логику, до верификации — проверки того, что проект будет корректно работать после физической реализации. Значительную часть бэкенда, куда входят трассировка межсоединений, доводка и проверка схем тактирования и питания, а также подготовка и передача на фабрику необходимых данных, выполнила Broadcom, которая и провела чип через производство.
Бэкенд, или физическое проектирование, превращает логическое описание в геометрию кристалла: огромное число транзисторов нужно разместить и соединить так, чтобы сигналы успевали проходить по цепям за отведённое время. Именно здесь доминируют проприетарные EDA-пакеты, а ошибки обходятся особенно дорого, ведь их порой обнаруживают уже на готовом кремнии.
При этом OpenAI не оставила бэкенд без внимания. В команде Jalapeño есть инженеры по физическому проектированию, которые вместе с коллегами из Broadcom давали рекомендации, в частности, по планировке кристалла и трассировке. На конференции Hot Chips 2026 — ежегодном симпозиуме, где разработчики раскрывают архитектурные подробности самых производительных процессоров и ускорителей, — Хо и Лири привели конкретные цифры. Оптимизация физического проектирования под руководством ИИ позволила сократить площадь блоков матричного умножения на 10% по сравнению с оптимизированным вариантом, выполненным людьми.
Иначе говоря, по утверждению OpenAI, ИИ помог уместить на той же площади кремния больше схем, чем было бы возможно раньше. Матричные умножения составляют основу вычислений в нейросетях, поэтому экономия площади в соответствующих блоках особенно ценна: на освободившемся месте можно разместить дополнительную логику.
Broadcom при этом работала по собственному внутреннему процессу. У её специалистов не было доступа к внутренним моделям, с помощью которых OpenAI проектировала Jalapeño, но публичными коммерческими моделями OpenAI они пользоваться могли.
Рави Кришна из Verkor.io считает, что подход OpenAI к бэкенду уже выглядит несколько консервативным, и объясняет это временем работы над проектом, стартовавшим в октябре 2024 года. «Модели последних четырёх-пяти месяцев стали лучше. Примерно с апреля 2026 года они действительно начали заметно лучше справляться с такими задачами», — говорит он. С ним согласен ещё один сооснователь Verkor.io, Суреш Кришна: по его мнению, «нет никаких причин, по которым агентный цикл не мог бы в значительной степени ускорить и бэкенд-часть процесса». Под агентным циклом понимается схема, в которой модель сама запускает инструменты, анализирует результаты и вносит исправления, повторяя шаги до достижения цели.
Второе поколение: больше ИИ, но без полной автоматизации
Хо и Лири также намекнули, что по сравнению со следующими проектами команды процесс разработки Jalapeño может показаться старомодным.
«С Jalapeño, как нетрудно догадаться, мы старались двигаться максимально быстро. Поэтому приходилось выбирать: потратить время на какие-то инновации или делать то, что исторически работает. Второе поколение даёт нам своего рода возможность начать с чистого листа и решить, что мы хотим выстроить», — объясняет Крис Лири.
По словам Хо, в процессе разработки чипа второго поколения «есть много мест, куда мы внедряем ИИ». В частности, он видит возможности шире применять его в верификации и физическом проектировании. Лири добавляет, что у команды уже есть инструменты для автоматической обработки и просмотра временных диаграмм сигналов. Они автоматизируют анализ, помогая находить тактовые сигналы, связанные со сбоями, и могут упростить отладку аппаратуры ещё на этапе проектирования.
Временные диаграммы — это записи того, как меняется каждый сигнал схемы при симуляции такт за тактом. В крупном проекте они охватывают огромное количество сигналов, и ручной поиск момента, когда что-то пошло не так, отнимает у инженеров много времени.
Несмотря на ожидаемые улучшения, Хо и Лири ясно дали понять, что не считают возможной полную автоматизацию проектирования чипов. «Мы не утверждаем, что кто угодно может прийти и построить передовой ускоритель для ИИ и машинного обучения, используя одну лишь Codex, — поясняет Хо, имея в виду платформу OpenAI для программирования. — Мы говорим о вполне конкретных вещах: как эффективнее работать с Codex и как, делая ставку на небольшую команду и сжатые сроки, добиваться качественных результатов».
Опыт OpenAI показывает, как может меняться экономика разработки собственных чипов: если небольшая команда с помощью ИИ проходит путь от RTL до тейпаута за девять месяцев, заказные ускорители становятся реальной альтернативой готовым решениям для всё большего числа компаний. Насколько хорошо этот подход масштабируется, покажут второе и третье поколения ускорителей OpenAI, а также то, как быстро Jalapeño войдёт в реальную эксплуатацию.